U bent hier:
Wat zijn gegevensbibliotheken?
Agentforce gegevensbibliotheken verbeteren de nauwkeurigheid van AI-voorzieningen zoals Agentforce Agents door ze te verbinden met uw vertrouwde gegevensbronnen. Gegevensbibliotheken gebruiken ongestructureerde of semigestructureerde gegevens, zodat ze grote sets informatie die op het web, in documenten of als grote tekstinvoer in velden voorkomen, kunnen omzetten in nuttigere, doorzoekbare informatie.
Wanneer u een gegevensbibliotheek maakt, automatiseert deze diverse configuratiestappen binnen Data 360 en Aanwijzingensamensteller, zoals het pushen van gegevensstromen naar Data 360, het toewijzen van gegevensobjecten en het maken van een zoekindex en retriever. Als deze stappen automatisch worden uitgevoerd, kunt u agenten gemakkelijk koppelen aan uw gegevens. U kunt bibliotheken maken en configureren vanuit de set-up van Agentforce Gegevensbibliotheek of via Agentforce Builder.
Aarden, blokken en indexeren
Aarding voegt domeinspecifieke Knowledge of klantinformatie toe aan de aanwijzing, waardoor de LLM context krijgt om nauwkeuriger te reageren op een vraag of taak. Aardingsbronnen kunnen Knowledge artikelen, geüploade bestanden of gesprekstranscripties bevatten. Lange en ingewikkelde Knowledge artikelen en geüploade bestanden kunnen een aanzienlijke hoeveelheid tijd en verwerkingskracht vergen om de juiste informatie te doorzoeken, terwijl LLM's een maximale token- of woordlimiet hebben voor de hoeveelheid tekst die ze in één gesprek kunnen verwerken. Om de zoekopdracht efficiënter te maken, de relevantie te verbeteren en zeer grote gegevenssets af te handelen, splitsen we gegevensbronnen op in kleinere delen die blokken worden genoemd. Veel typen gegevens kunnen in blokken worden verdeeld, inclusief tekst, afbeeldingen en zelfs audiobestanden.
Nadat gegevens in blokken zijn gesplitst, worden ze geïndexeerd, of geordend en gecategoriseerd. Indexering vereenvoudigt het zoeken en ophalen van gegevensblokken voor AI-tools. Wanneer een AI-agent informatie nodig heeft of een gebruiker een vraag stelt, gebruiken we de zoekindex om in de blokken te sorteren en de blokken te vinden die het meest relevant zijn voor een bepaalde query of taak. Elk blok in de zoekindex wordt vergeleken met een gelijksoortigheidsscore die aangeeft hoeveel van de tekst tussen de query en het blok overeenkomt. Brokken met een hoge gelijksoortigheidsscore verwijzen naar relevante artikelen of bronnen, die vervolgens worden geretourneerd en toegevoegd aan de aanwijzing. Door middel van deze strategie kunnen we relevante, contextspecifieke informatie toevoegen aan een aanwijzing zonder de tokenlimiet te overschrijden, terwijl de LLM responsen kan opstellen die passen bij verschillende situaties en organisaties.
Retrievers
Retrievers fungeren als verwijzingen tussen gegevens en voorzieningen. Ze zijn ontworpen om automatisch relevante gegevens uit verschillende databases, systemen of platforms te extraheren en aan te bieden, waardoor handmatige gegevensverzameling wordt verminderd en tegelijkertijd de opgehaalde gegevenssets worden gestandaardiseerd. Retrievers zijn met name belangrijk in toepassingen zoals zoekmachines, vraag-antwoordsystemen en aanbevelingssystemen. Wanneer een gebruiker een vraag stelt of hulp krijgt van AI, bepaalt de retriever die u toewijst aan elke gegevensbibliotheek welke gegevenssets in Data 360 beschikbaar zijn voor AI-tools in Salesforce. Zie Ophalen Uitgebreid genereren gebruiken.
Wat gebeurt er wanneer u een gegevensbibliotheek maakt?
De processen die uw gegevens verbinden met uw AI-agenten en -voorzieningen, starten zodra u uw gegevensbibliotheek configureert en opslaat. Eerst wordt er een gegevensstroom gemaakt, gevolgd door de gegevens-lake- en gegevensmodelobjecten. Vervolgens wordt het gegevens-lakeobject toegewezen aan het gegevensmodelobject. Nadat de gegevens-lake- en modelobjecten zijn toegewezen, wordt de zoekindex gemaakt. Voor het maken van de zoekindex moeten de vorige stappen succesvol en actief zijn.
Nadat u een zoekindex hebt gemaakt, begint het blokken van gegevens. De opdeeltijd is afhankelijk van factoren zoals het aantal, de grootte en complexiteit van Knowledge artikelen of geüploade bestanden, en het aantal Knowledge velden dat is geselecteerd voor opdelen in blokken. Bestaande gegevensbibliotheken voor zoeken op het web zijn alleen-lezen en maken geen zoekindex, alleen een retriever. Voor op bestanden of Knowledge gebaseerde bibliotheken wordt de retriever gemaakt nadat het in blokken verdelen is voltooid en de zoekindex gereed is. Elke Agentforce gegevensbibliotheek heeft zijn eigen retriever, ongeacht de instellingen. Retrievers kunnen naar dezelfde zoekindex verwijzen, maar elke wijzer is uniek.
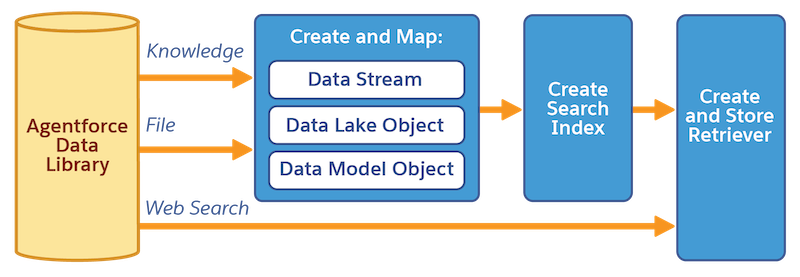
U kunt elke stap bewaken vanaf de statuskaart op de set-uppagina van de gegevensbibliotheek. De statuskaart loodst u door elke fase terwijl deze wordt voltooid, en koppelt naar de onderliggende Data Cloud-objecten in Data 360 zodat u de volledige gegevenspijplijn kunt inspecteren en beheren.
Wanneer de index klaar is en de retriever is gemaakt, kunnen klanten de configuratie van de gegevensbibliotheek gebruiken met hun AI-agenten en -voorzieningen.
Hoe werken gegevensbibliotheken tijdens run-time?
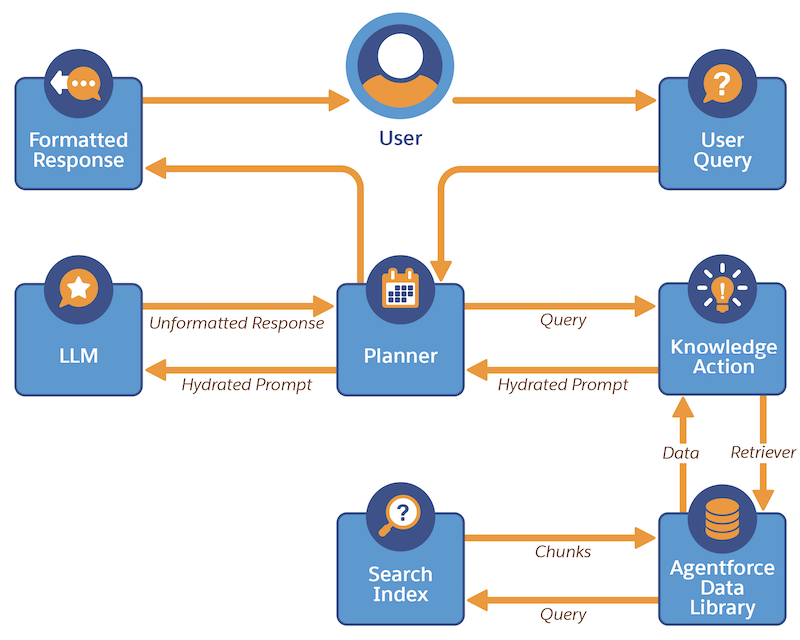
Tijdens run-time wordt de query van de gebruiker toegevoegd aan de aanwijzingssjabloon, die verwijst naar een retriever die verbinding maakt met relevante gegevens. Het systeem doorzoekt vervolgens de zoekindex om de meest relevante informatie te vinden en neemt deze weer op in de aanwijzing. De LLM ontvangt deze verrijkte aanwijzing en gebruikt de query van de gebruiker, de toegevoegde informatie en de aanwijzingsinstructies om een respons te genereren. De serviceplanner controleert deze respons vervolgens om ervoor te zorgen dat deze overeenkomt met de aanwijzingen. Ten slotte ontvangt de eindgebruiker een antwoord dat de query beantwoordt in een context met relevante, domeinspecifieke informatie en afgestemd op de specifieke taak.
Agentacties en gegevensbibliotheken
Acties bepalen welke taken een agent kan uitvoeren. Standaardacties zijn standaard inbegrepen bij uw agenten en kunnen worden samengesteld om met specifieke producten te werken. Wanneer een gebruiker bijvoorbeeld een vraag stelt aan een AI agent, wordt de actie Vragen beantwoorden met Knowledge agent gebruikt om de query te beantwoorden op basis van gegevens in de corresponderende Agentforce gegevensbibliotheek. Zie Vragen beantwoorden met Knowledge Action en Agent Action: Beantwoord vragen met Knowledge.
