Sie befinden sich hier:
Registerkarte "Kreuzvalidierung" für Binär-Klassifizierungsanwendungsfälle
Zum Testen der Fähigkeit eines Modells, Prognosen abzugeben, verwendet Einstein Discovery die k-fache Kreuzvalidierung, einen Prozess, der die Stichprobenverzerrung beim Validieren eines Modells reduziert. Auf dieser Registerkarte werden die Ergebnisse des Kreuzvalidierungsprozesses für dieses Modell sowie einige zugrunde liegende Berechnungsdetails zusammengefasst.

Navigieren zur Registerkarte "Kreuzvalidierung"
Klicken Sie unter "Leistung" auf Modellauswertung und dann auf Kreuzvalidierung.
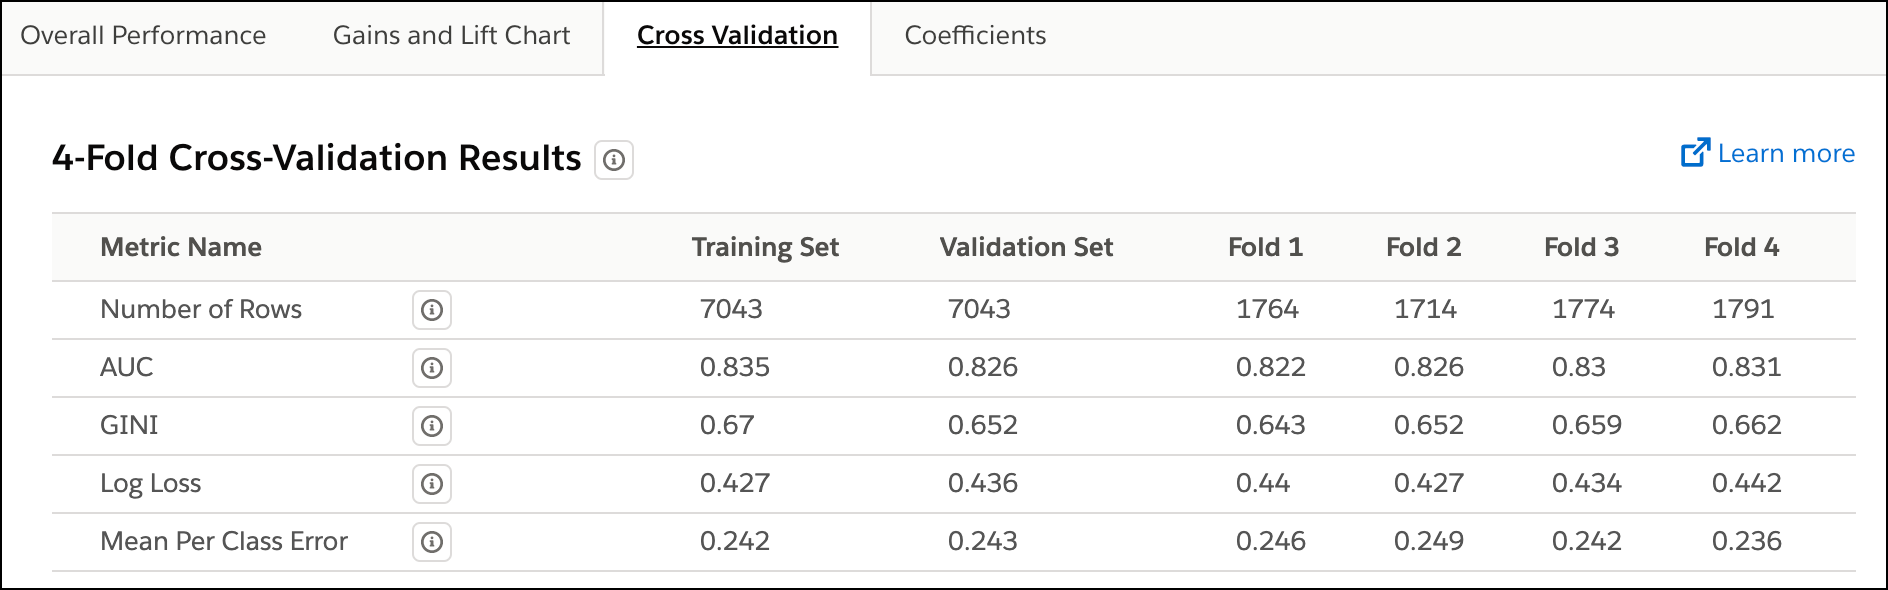
Spalten auf der Registerkarte "Kreuzvalidierung"
Die folgende Tabelle beschreibt die Spalten der Registerkarte "Kreuzvalidierung".
| Spaltenname | Beschreibung |
|---|---|
| Metrikname | Der Name der Kennzahl. |
| Trainingsset | Kennzahlen für den Satz von Beobachtungen im CRM Analytics-Datenset, den Einstein Discovery zum Trainieren des Modells verwendet. |
| Validierungsset | Kennzahlen für den Satz von Beobachtungen im CRM Analytics-Datenset, den Einstein Discovery zur Validierung der durch das trainierte Modell erzeugten Prognosen verwendet. |
| Teilmenge 1 | Kennzahlen für die erste Teilmenge. |
| Teilmenge 2 | Kennzahlen für die zweite Teilmenge. |
| Teilmenge 3 | Kennzahlen für die dritte Teilmenge. |
| Teilmenge 4 | Kennzahlen für die vierte Teilmenge. |
Kennzahlen auf der Registerkarte "Kreuzvalidierung"
Die folgende Tabelle beschreibt die Kennzahlen auf der Registerkarte "Kreuzvalidierung".
| Metrikname | Beschreibung |
|---|---|
| Zeilenanzahl | Gesamtzahl der Beobachtungen. Die Bedeutung eines Werts variiert je nach Spalte.
|
| AUC | Fläche unter der Kurve (Area Under the Curve). Stellt die Quote für die richtige Klassifizierung durch ein logistisches Modell dar. Die AUC ist die am besten geeignete Kennzahl für Klassifizierungsanwendungsfälle. Bereich:
|
| GINI | GINI-Index. Quantifiziert, wie nahe das erhaltene Modell dem theoretisch bestmöglichen Modell kommt. Bereich:
|
| Logarithmischer Verlust | Logarithmischer Verlust. Misst die Modellleistung auf einer Skala von 0 bis 1, wobei 0 für ein perfektes Modell steht (die prognostizierte Wahrscheinlichkeit stimmt mit einer Richtigkeit von 100 % mit den tatsächlichen Beobachtungen überein). Je weniger richtig die prognostizierte Wahrscheinlichkeit mit den tatsächlichen Beobachtungen übereinstimmt (geringere Leistung), desto höher ist der logarithmische Verlust. Mit dem logarithmischen Verlust wird die Unsicherheit bei der Modellleistung berücksichtigt. |
| Mittelwert pro Klassenfehler (Mean Per Class Error) | Misst, wie oft die Prognosen falsch sind. Geringere Werte bedeuten, dass die Prognosen seltener falsch sind und das Modell daher bei Prognosen besser ist. |
Methodik zur Modellvalidierung
Einstein Discovery führt eine k-fache Kreuzvalidierung (k=4) für Ihr Modell aus. Dieser Prozess umfasst die folgenden Schritte:
- Die Beobachtungen im CRM Analytics-Datenset werden nach dem Zufallsprinzip in vier separate Partitionen gleicher Größe aufgeteilt.
- Es werden vier Testläufe (Teilmengen) ausgeführt, in denen drei Partitionen als Trainingsset und eine Partition als Testset fungieren.Hinweis Nach Abschluss der vier Testläufe wurde jede Partition einmal als Validierungsset und dreimal als Teil des Trainingssets bereitgestellt.
- Kompilieren Sie für jede Teilmenge die Modellkennzahlen.
- Berechnen Sie den Durchschnitt der vier Teilmengen für eine Gesamtbewertung.
