Vous êtes ici :
Onglet Validation croisée pour les cas d'utilisation de classification binaire
Pour tester la capacité d'un modèle à générer des prédictions, Einstein Discovery utilise la validation croisée k échantillons, un processus qui réduit les biais d'échantillonnage lors de la validation d'un modèle. Cet onglet présente les résultats du processus de validation croisée pour ce modèle, avec quelques détails calculés sous-jacents.

Accès à l'onglet Validation croisée
Dans Performance, cliquez sur Évaluation du modèle, puis sur Validation croisée.
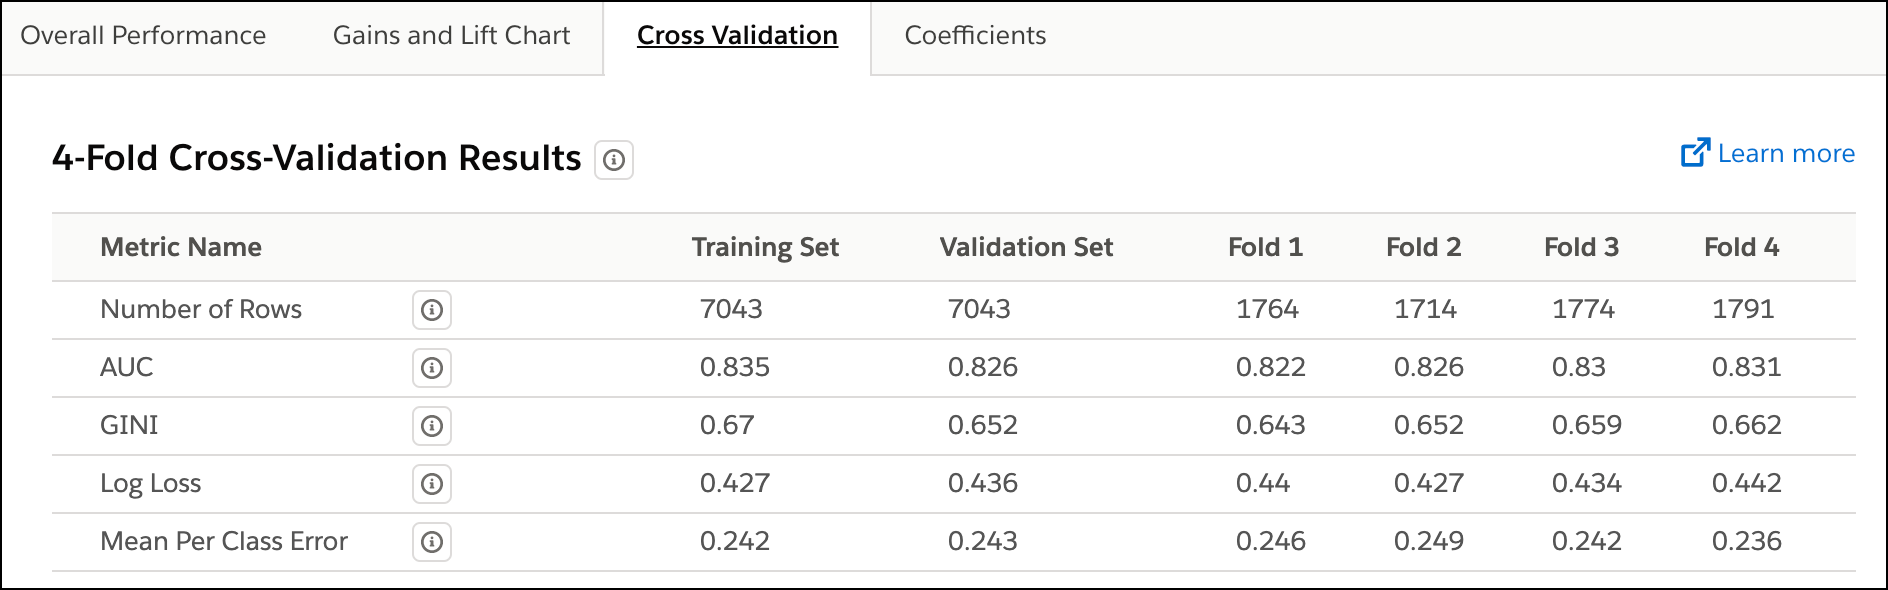
Colonnes sous l'onglet Validation croisée
Le tableau ci-dessous présente les colonnes de l'onglet Validation croisée.
| Nom de la colonne | Description |
|---|---|
| Nom de la métrique | Le nom de la métrique. |
| Ensemble d'apprentissage | Métriques de l'ensemble d'observations dans le jeu de données CRM Analytics utilisé par Einstein Discovery pour entraîner le modèle. |
| Ensemble de validation | Métriques de l'ensemble d'observations dans le jeu de données CRM Analytics utilisé par Einstein Discovery pour valider les prédictions générées par le modèle entraîné. |
| Échantillon n° 1 | Métriques du premier échantillon. |
| Échantillon n° 2 | Métriques du deuxième échantillon. |
| Échantillon n° 3 | Métriques du troisième échantillon. |
| Échantillon n° 4 | Métriques du quatrième échantillon. |
Métriques sous l'onglet Validation croisée
Le tableau ci-dessous présente les métriques de l'onglet Validation croisée.
| Nom de la métrique | Description |
|---|---|
| Nombre de lignes | Nombre total d'observations. La signification de la valeur varie par colonne.
|
| AUC | L'aire sous la courbe. Représente le taux de classification correct par un modèle logistique. AUC est la métrique la plus appropriée à utiliser pour les cas d'utilisation de classification. Plage :
|
| GINI | Index GINI. Quantifie les performances du modèle obtenu en le comparant au meilleur modèle théorique possible. Plage :
|
| Perte logarithmique | Perte logarithmique. Mesure les performances du modèle sur une échelle de 0 à 1, où 0 représente un modèle parfait (la probabilité prédite correspond à 100 % aux observations réelles). Moins la probabilité prédite correspond aux observations réelles (performance inférieure), plus la perte logarithmique est importante. La perte logarithmique prend en compte les incertitudes dans les performances du modèle. |
| Erreur moyenne par classe | Mesure la fréquence à laquelle les prédictions sont incorrectes. Les valeurs basses indiquent que les prédictions sont moins souvent incorrectes et, par conséquent, que le modèle génère de meilleures prédictions. |
Méthodologie de validation du modèle
Einstein Discovery effectue une validation croisée k échantillons (échantillons=4) sur votre modèle. Ce processus implique les étapes suivantes :
- Diviser de façon aléatoire toutes les observations dans le jeu de données CRM Analytics en quatre partitions distinctes de taille égale.
- Exécuter quatre tests (échantillons) dans lesquels trois partitions servent d'ensemble d'apprentissage et une partition sert d'ensemble de test.Remarque Une fois les quatre tests effectués, chaque partition a servi une fois en tant qu'ensemble de validation et trois fois dans l'ensemble d'apprentissage.
- Pour chaque échantillon, compiler les métriques de modèle.
- Prendre la moyenne des quatre échantillons pour un score global.
