Вы находитесь здесь:
Вкладка перекрестной проверки для сценариев числового использования
Чтобы проверить способность модели создавать прогнозы, Einstein Discovery использует k-кратную перекрестную проверку, процесс, который уменьшает предвзятость выборки при проверке модели. Данная вкладка резюмирует результаты процесса перекрестной проверки для этой модели, а также некоторые основные вычислительные сведения.

Переход ко вкладке перекрестной проверки
В производительности нажмите «Оценка модели», потом нажмите «Перекрестная проверка».
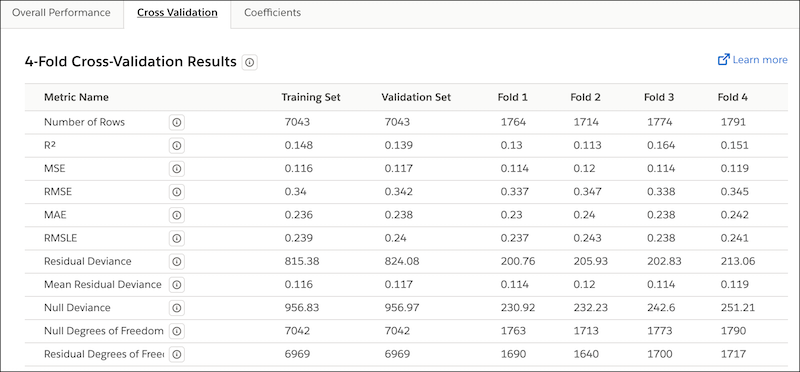
Столбцы во вкладке перекрестной проверки
| Имя столбца | Описание |
|---|---|
| Имя показателя | Имя показателя. |
| Обучающий набор | Показатели для набора наблюдений в наборе данных CRM Analytics, используемые Einstein Discovery для обучения модели. |
| Проверочный набор | Показатели для набора наблюдений в наборе данных CRM Analytics, используемые Einstein Discovery для проверки прогнозов, созданных обученной моделью. |
| Папка №1 | Показатели для первого прогона. |
| Папка №2 | Показатели для второго прогона. |
| Папка №3 | Показатели для третьего прогона. |
| Папка №4 | Показатели для четвертого прогона. |
Показатели во вкладке перекрестной проверки
Вкладка перекрестной проверки отображает следующие показатели для модели.
| Имя показателя | Описание |
|---|---|
| Количество строк | Общее количество наблюдений. Значение меняется в каждой колонке.
|
R2 |
R2 измеряет способность модели объяснять вариативность результата, являющуюся индикатором прогнозируемости модели. Диапазон:
|
| MSE | Средняя квадратичная ошибка. Измеряет среднюю квадратичную ошибку прогнозов модели. MSE рассчитывает квадратичную разницу между обозримым (фактическим) результатом и прогнозируемыми значениями, а потом своди их к среднему значению. |
| RMSE | Корень средней квадратичной ошибки. Представляет квадратный корень средней квадратичной ошибки. RMSE определяет разницу между значениями, прогнозированными моделью и обозримыми (фактическими) значениями. Это значение является «стандартным отклонением ошибок». |
| MAE | Средняя абсолютная ошибка. Определяет абсолютную разницу между фактическим значением и прогнозом. Благодаря равному весовому значению всех разниц, чувствительность данного показателя к выпадающим значениям гораздо ниже, чем у средней квадратичной ошибки (MSE). |
| RMSLE | Корень средней квадратичной логарифмической ошибки. Сравните с RMSE:
|
| Остаточное отклонение | Определяет эффективность разработанной модели в вашем наборе данных.
|
| Среднее остаточное отклонение | Определяет эффективность модели в вашем наборе данных. Низкие значения обозначают лучшее соответствие. |
| Нулевое отклонение | Определяет эффективность простой модели в вашем наборе данных. Низкие значения обозначают лучший результат. Таким образом, если нулевое отклонение низкое, ваши данные не слишком сложные. |
| Нулевые степени свободы | Представляет распределение хи-квадрат нулевого отклонения. |
| Остаточные степени свободы | Представляет распределение хи-квадрат остаточного отклонения. |
Методики проверки модели
Einstein Discovery проводит перекрестную проверку модели в k раз (k=4). Это процесс состоит из следующих этапов:
- Случайное разделение всех наблюдений в наборе данных CRM Analytics на четыре отдельные части равного размера.
- Выполнение четырех прогонов теста (кратность прогонов), в которых три части используются как учебный набор,а одна часть - как тестовый набор.Примечание После выполнения четырех прогонов каждая из частей один раз используется в качестве набора проверки, а три раза - как составная учебного набора.
- Для каждого раза составьте показатели модели.
- Используйте среднее значение четырех выполнений для общей оценки.
