Du er her:
Kryssvalidering-fanen for brukstilfeller med klassifisering med flere klasser
For å teste en modells evne til å gjøre forutsigelser bruker Einstein Discovery k-veis kryssvalidering, en prosess som reduserer forventningsskjevhet for sampling ved validering av modellen. Denne fanen oppsummerer resultatene av kryssvalideringsprosessen for modellen, i tillegg til noen underliggende beregningsdata.

Merk Einstein Discovery-historier er nu modeller. Vi ønsker at vi kan ta bare et finger for å oppdatere navnet overalt, men du kan forvente å se det forrige navnet noen få steder til vi erstatter det.
Navigere til fanen Kryssvalidering
Klikk på Modellevaluering i Perfomance, og klikk deretter på Kryssvalidering.
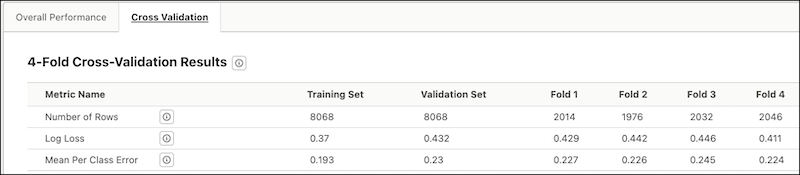
Kolonner på fanen Kryssvalidering
| Kolonnenavn | Beskrivelse |
|---|---|
| Målingsnavn | Navnet på målingen. |
| Opplæringssett | Målinger for settet av observasjoner i CRM Analytics-datasettet som Einstein Discovery bruker for å lære opp modellen. |
| Valideringssett | Målinger for settet av observasjoner i CRM Analytics-datasettet som Einstein Discovery bruker for å validere forutsigelsene som er generert av den opplærte modellen. |
| Gang nr. 1 | Målinger for første omgang. |
| Gang nr. 2 | Målinger for andre omgang. |
| Gang nr. 3 | Målinger for tredje omgang. |
| Gang nr. 4 | Målinger for fjerde omgang. |
Målinger på fanen Kryssvalidering
| Målingsnavn | Beskrivelse |
|---|---|
| Antall rader | Totalt antall observasjoner. Betydningen av en verdi varierer avhengig av kolonnen.
|
| Logaritmisk tap | Logaritmisk tap. Måler modellresultatene på en skala fra 0 til 1 der 0 representerer en perfekt modell (den forutsagte sannsynligheten samsvarer 100 % riktig med de faktiske observasjonene). Jo lavere den forutsagte sannsynligheten samsvarer riktig med de faktiske observasjonene (dårligere resultater), desto høyere er det logaritmiske tapet. Logaritmisk tap vurderer usikkerheten i modellresultatene. |
| Gjennomsnittsfeil per klasse | Måler hvor ofte forutsigelsene er feil. Lavere verdier betyr at forutsigelsene sjeldnere er feil, og modellen lager derfor bedre forutsigelser. |
Modellvalideringsmetodologi
Einstein Discovery utfører k-veis kryssvalidering (k=4) på modellen. Denne prosessen involverer følgende trinn:
- Dele alle observasjonene i CRM Analytics-datasettet vilkårlig inn i fire separate partisjoner som er like store.
- Utføre fire testrunder (omganger) der tre av partisjonene fungerer som opplæringssett og én partisjon fungerer som testsett.
Merk Når de fire testrundene er fullført, har hver partisjon fungert én gang som valideringssett og tre ganger som en del av opplæringssettet.
- Kompilere modellmålinger for hver omgang.
- Ta gjennomsnittet av de fire omgangene som totalscore.
Hjalp denne artikkelen med å løse problemet ditt?
La oss få vite det slik at vi kan forbedre!
