Usted está aquí:
Ficha Rendimiento general para casos de uso de clasificación binaria
La fichas Rendimiento general muestra mediciones clave de resumen para la calidad del modelo.

Navegar a la ficha Rendimiento general
En Rendimiento, haga clic en Evaluación de modelo, luego haga clic en Rendimiento general.
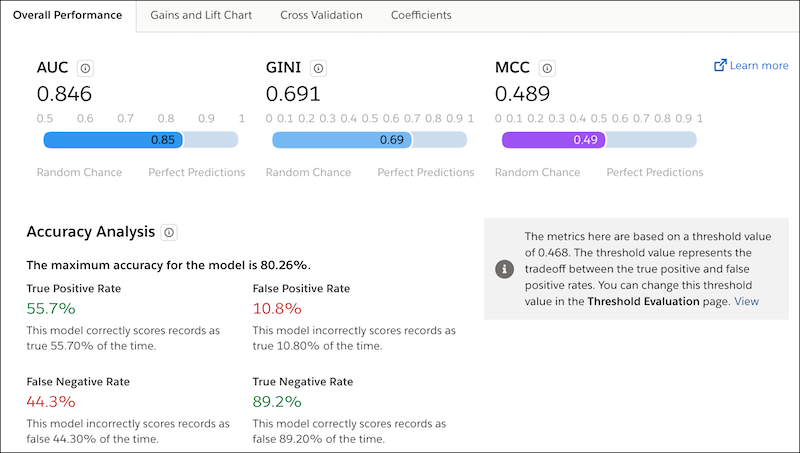
Mediciones de resumen
| Métrico | Descripción |
|---|---|
| AUC | Área bajo la curva. Mide el índice de clasificación correcta del modelo logístico. AUC se utiliza frecuentemente para evaluar la calidad del modelo en casos de uso de clasificación. Intervalo:
|
| GINI | Índice GINI. Mide cuánto se acerca el rendimiento de este modelo de clasificación a un modelo teóricamente mejor posible. Intervalo:
|
| MCC | Coeficiente de correlación de Matthews. Mide la calidad de un modelo de clasificación. Proporciona aún más representación de las cuatro partes de la matriz de confusión que otras mediciones de clasificación. Por lo contrario, la precisión y la puntuación F1 pueden inducir a errores cuando se predice una clase con mucha más precisión que otra en un caso de uso de clasificación. Intervalo:
|
Análisis de precisión
La precisión mide la proporción de resultados que el modelo predijo correctamente.
Fórmula:
Precisión = (TP + TN) / Nº total de predicciones
dónde
- TP representa el número de positivos verdaderos (predicción positiva con un resultado positivo)
- TN representa el número de negativos verdaderos (predicción negativa con un resultado negativo)
- No total de predicciones que el modelo realizó (tanto correctas como incorrectas)
| Medición | Descripción |
|---|---|
| La precisión máxima para este modelo es | La precisión máxima para este modelo. |
| Tipo de positivo verdadero | Este modelo puntúa correctamente registros como verdaderos el n% de las veces. |
| Tipo de negativo verdadero | Este modelo puntúa correctamente registros como falsos el n% de las veces. |
| Tipo de falso positivo | Este modelo puntúa incorrectamente registros como verdaderos el n% de las veces. |
| Tipo de negativo falso | Este modelo puntúa incorrectamente registros como falsos el n% de las veces. |
| Valor del umbral | El valor del umbral representa las ventajas entre los tipos positivos verdaderos y los tipos positivos falsos. Puede ajustar esta configuración de umbral en la Evaluación de umbral para casos de uso de clasificación binaria. |
