詳細情報:
データオプションの選択
Einstein が分析して予測モデルの構築に使用するデータセットの変数を手動で選択および設定します。

-
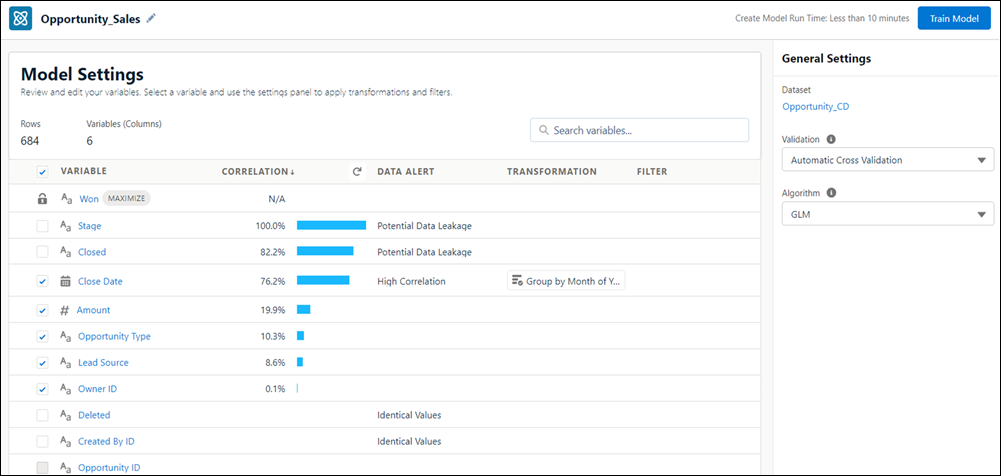
テーブルを使用して、モデルに含める変数を選択します。2 ~ 49 個の変数を選択してください。
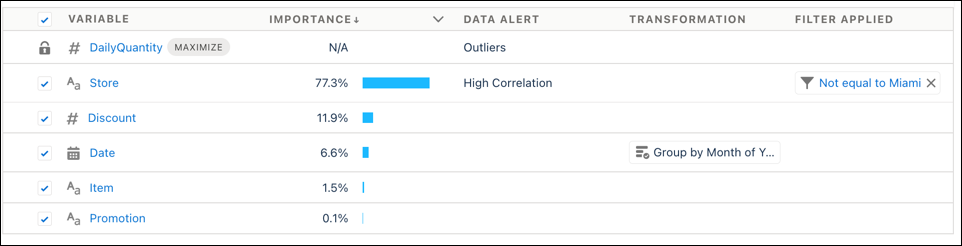
列 説明 選択 モデルに変数を含めるには、チェックボックスをオンにします。
メモ ロックアイコンが表示されている行は、モデルの結果変数または対象であることを示しています。これは、モデルに自動的に含まれます。オフにすることはできません。変数 データセット列または項目。機能変数とも呼ばれます。各行はデータセットの列を表し、数値、テキスト、または日付変数としてマークされます。
列ヘッダーをクリックして、テーブルを変数で昇順または降順に並び替えます。
メモ- 変数のリストには、データセットのデータが 25 行以上の数値、テキスト、および日付列が含まれます。
- 複数値項目 (リストや配列など、複数の値を含む項目) は、Einstein Discovery ではサポートされません。詳細は、「Einstein Discovery の容量と要件」を参照してください。
重要度または相関関係 Einstein には、含める変数を決定するのに役立つ評価指標が表示されます。相関関係は変数と結果の間の関連付けの強さを示し、重要度は結果の予測でモデルが変数をどのくらい使用するかを示します。たとえば、エネルギー使用量を予測する場合、最も相関関係が高いのは温度ですが、最も重要なのはエアコンの種類である場合があります。
確認する内容を選択するには、列のドロップダウンメニューを使用します。
- [重要度] では、変数がどの程度結果に影響するかが示されます。重要度は、結果の予測時にモデルが変数を使用する度合を示します。重要性が高いほど、影響が大きくなります。
- [相関関係] では、変数がどの程度結果に関連付けられているかが示されます。相関関係が高いほど、変数と結果の間の関係は強くなります。
 ヒント
- これらの評価指標を使用して、相対的に変数を評価します。絶対値ではなく、上下を考慮します。
- 重要度と相関関係が異なる場合のベストプラクティスは、重要度を考慮することです。重要度のほうが、変数間のインタラクションを理解する評価指標として高度です。たとえば、グローバルセールスを予測するときに、商品と地域は個々の相関関係は弱い場合がありますが、組み合わせると重要度が高くなります。
- 重要度や相関関係が非常に低いかない場合は、その変数を選択解除してモデルを改善することを検討します。
データアラート データアラートが表示されます。 変換 変換、または設定済みの変更が表示されます。 適用された検索条件 除外する値が表示されます。 -
個々の変数の設定を定義するには、テーブル内で選択して右パネルを使用します。
各変数について、Einstein では最大 100 個の値が使用されます。変数に 100 個を超える値がある場合、最も頻繁に出現する値が使用され、残りは [その他] にグループ化されます。変数で使用される値の数を 200 個に増やすには、高カーディナリティを有効にします。詳細は、「高カーディナリティアラート」を参照してください。
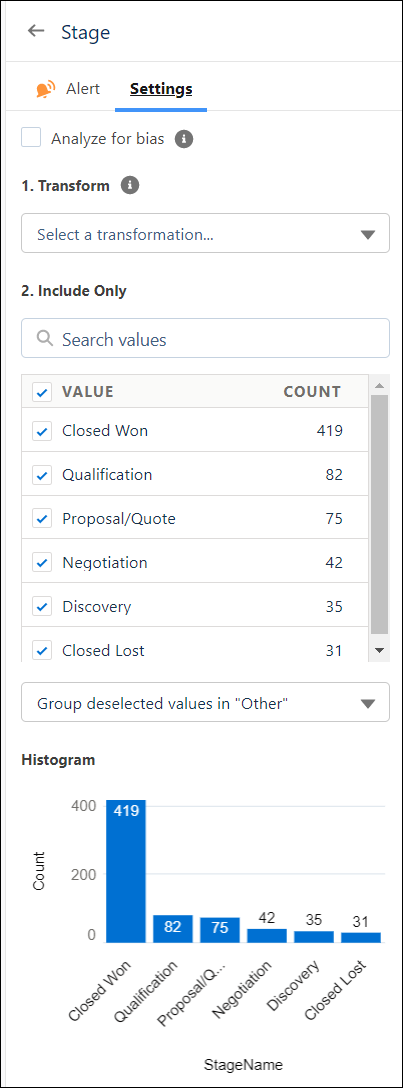
タブ 説明 アラート データで検出された問題の可能性 (異常値や重複など) を識別します。アラートと推奨アクションを確認して、より適切なインサイト、予測、および改善を取得します。詳細は、「品質アラートの処理」を参照してください。 設定 バイアスの分析 — テキスト変数をバイアス検出の対象にするように選択し、分析や予測に対する悪影響や非倫理的な影響を排除できるようにします。詳細は、「モデルからのバイアスの検出と削除」を参照してください。
変換 — 変数の設定で変換を使用して、分析用のデータを改善します。変換はモデルに影響し、データセットには影響しません。
メモ 適用すると、変換ではデータセットの変数のすべての値が使用されます。手順については、以下を参照してください。
バケット — 数値変数の場合。
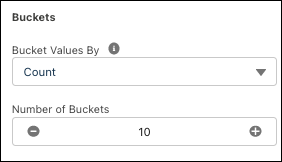
- [次の基準によるバケット値] ドロップダウンを使用してバケット化の方法を選択します。
- 件数: 出現に比例してバケット化します。
- 幅: 値の合計範囲内に比例してバケット化します。
- 手動: 独自のバケット範囲を指定します。
- バケット数を選択します。
次のみを含める — 変数に含まれる値 (表示ラベルや行数を含む) が表示されます。出現回数が 25 回未満の値は「その他」としてグループ化されます。
- 値をその他としてグループ化またはバケット化するには、選択解除してからドロップダウンで [選択解除された値を「その他」でグループ化] を選択します。
- 値を除外するには、選択解除してからドロップダウンで [選択解除された値を除外する] を選択します。
ヒント 変換後に検索条件を適用します。変換では、除外される値の検索条件は無視されます。ヒストグラム — グラフに出現回数、つまり行数別の値の分布が表示されます。
- [次の基準によるバケット値] ドロップダウンを使用してバケット化の方法を選択します。
-
右パネルで一般設定を定義します。
- Einstein Discovery がモデルの作成に使用するアルゴリズムを選択します。
アルゴリズム 説明 GLM デフォルト。一般化された線形モデルは、回帰ベースのアルゴリズムです。 GBM 勾配ブーストマシンは、ディシジョンツリーベースのアンサンブル機械学習アルゴリズムです。 XGBoost XGBoost は、ディシジョンツリーベースのアンサンブル機械学習アルゴリズムです。 ランダムフォレスト ランダムフォレストは、複数のディシジョンツリー、ランダマイゼーション、および他の最適化技法を使用する教師あり学習アルゴリズムです。 モデルトーナメント または、Einstein Discovery で 4 つすべてのアルゴリズムを実行し、その後最もパフォーマンスの高かったアルゴリズムを使用します。 - 必要に応じて、[検証オプション] ドロップダウンから選択し、検証セットを指定するかどうかを指定します。詳細は、「モデルの一般設定の編集」を参照してください。
- Einstein Discovery がモデルの作成に使用するアルゴリズムを選択します。
- [モデルを作成] をクリックします。
