U bent hier:
Opties voor gegevens selecteren
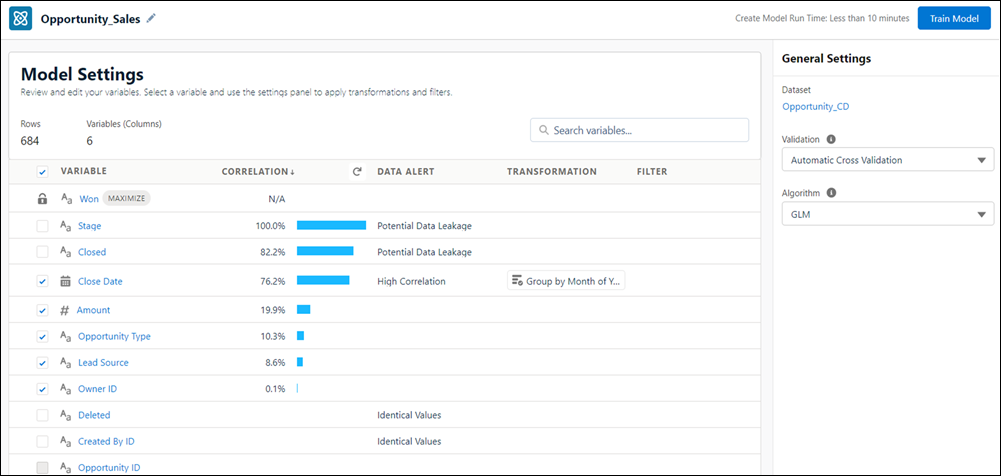
Selecteer en configureer handmatig de variabelen in uw gegevensset voor Einstein om deze te analyseren en te gebruiken voor het samenstellen van een voorspellend model.

-
Gebruik de tabel om te selecteren welke variabelen moeten worden opgenomen in het model. Selecteer minstens 2 en niet meer dan 49 variabelen.
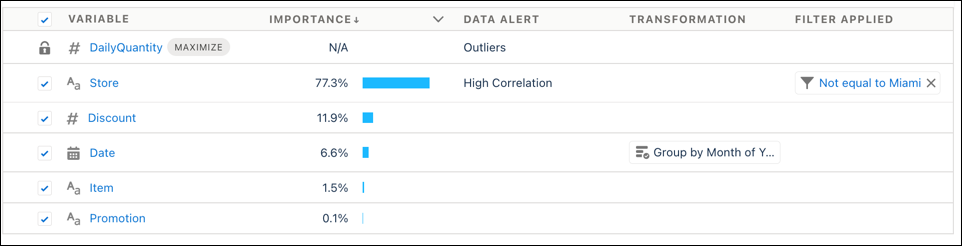
Kolom Beschrijving Selectie Schakel het selectievakje in om de variabele op te nemen in het model.
Opmerking De rij met het pictogram Vergrendelen geeft de uitkomstvariabele, of het doel, van het model aan. Deze wordt automatisch opgenomen in het model. De variabele kan niet worden uitgeschakeld.Variabele Kolom of veld van gegevensset. Ook wel functievariabele genoemd. Elke rij vertegenwoordigt een kolom in de gegevensset en is gemarkeerd als een getal-, tekst- of datumvariabele.
Sorteer de tabel op een variabele in oplopende of aflopende volgorde door te klikken op de kolomkop.
Opmerking- De lijst met variabelen omvat numerieke, tekst- en datumkolommen met minstens 25 rijen gegevens uit de gegevensset.
- Meervoudige-waardenvelden, velden die meerdere waarden bevatten (zoals een lijst of array), worden niet ondersteund in Einstein Discovery. Zie Einstein Discovery-mogelijkheden en -vereisten voor meer informatie.
Belangrijkheid of correlatie Einstein toont meetgegevens om u te helpen beslissen welke variabelen u moet opnemen. Correlatie toont de sterkte van de koppeling tussen de variabele en de uitkomst, en belangrijkheid toont de mate waarin het model de variabele gebruikt bij het voorspellen van de uitkomst. Wanneer u bijvoorbeeld energieverbruik voorspelt, is de Temperatuur de hoogste gecorreleerde waarde, terwijl het type airconditioner het belangrijkste is.
Als u wilt kiezen wat u wilt zien, gebruikt u het vervolgkeuzemenu van de kolom.
- Belangrijkheid toont hoe sterk de variabele de uitkomst beïnvloedt. Belangrijkheid geeft aan in hoeverre het model ervoor kiest om de variabele te gebruiken bij het voorspellen van de uitkomst. Hoe belangrijker, hoe groter de impact.
- Correlatie toont in welke mate de variabele is gekoppeld aan de uitkomst. Hoe hoger de correlatie, des te sterker de relatie tussen de variabele en de uitkomst.
 Tip
- Gebruik deze meetgegevens voor het evalueren van variabelen ten opzichte van elkaar. Houd rekening met bovenste en onderste waarden in plaats van absolute waarden.
- Wanneer belangrijkheid en correlatie verschillend zijn, is de best practice om rekening te houden met belangrijkheid. Belangrijkheid is een geavanceerder meetgegeven, dat de interacties tussen variabelen begrijpt. Wanneer bijvoorbeeld globale verkopen worden voorspeld, zijn product en regio afzonderlijk zwakke correlaties, terwijl ze samen uiterst belangrijk zijn.
- Als een variabele weinig of geen belangrijkheid of correlatie heeft, kunt u overwegen de selectie ervan op te heffen om het model te verbeteren.
Gegevenswaarschuwing Geeft gegevenswaarschuwingen weer. Transformatie Geeft transformaties of geconfigureerde wijzigingen weer. Filter toegepast Geeft uitgesloten waarden weer. -
Als u instellingen wilt configureren voor een afzonderlijke variabele, selecteert u deze in de tabel en gebruikt u het rechterdeelvenster.
Voor elke variabele gebruikt Einstein maximaal 100 waarden. Als de variabele meer dan 100 waarden heeft, worden de waarden die het vaakst voorkomen, gebruikt terwijl de rest wordt gegroepeerd in Overige. Schakel hoge kardinaliteit in om het aantal waarden in een variabele te verhogen tot 200. Zie Waarschuwing over hoge kardinaliteit voor meer informatie.
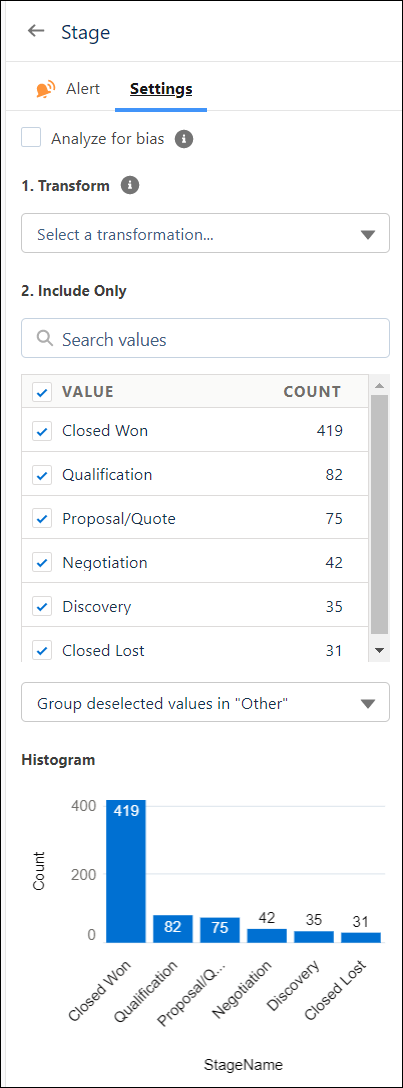
Tabblad Beschrijving Waarschuwing Identificeert mogelijke problemen die zijn gedetecteerd in de gegevens, zoals uitschieters of duplicaten. Controleer waarschuwingen en aanbevolen acties om betere insights, voorspellingen en verbeteringen te verkrijgen. Zie voor meer informatie Kwaliteitswaarschuwingen verwerken. Instellingen Analyseren om vertekening te herkennen: selecteer deze optie om vertekeningsdetectie op de tekstvariabele toe te passen, zodat u verstorende of onethische gevolgen voor uw analyse en voorspellingen kunt verwijderen. Zie Vertekening detecteren en verwijderen uit een model voor meer informatie.
Transformeren: gebruik transformaties in de instellingen van de variabele om gegevens voor analyse te verbeteren. Transformaties hebben invloed op het model en niet op de gegevensset.
Opmerking Wanneer ze worden toegepast, gebruiken transformaties alle waarden in de variabele uit de gegevensset.Zie voor instructies
Buckets: voor numerieke variabelen.
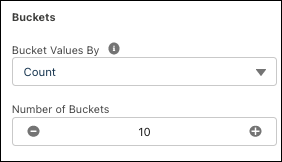
- Kies een bucketmethode met de vervolgkeuzelijst Bucketwaarden op.
- Telling: plaatst waarden proportioneel op voorkomen in buckets.
- Breedte: plaatst waarden proportioneel binnen het totale bereik van waarden in buckets.
- Handmatig: geef uw eigen bucketbereiken op.
- Selecteer het aantal buckets.
Alleen opnemen: geeft waarden in de variabele weer, inclusief het label en de rijtelling ervan. Waarden die minder dan 25 maal voorkomen, worden gegroepeerd als "Overig".
- Als u waarden wilt groeperen of in een bucket wilt plaatsen als overige, heft u de selectie ervan op en kiest u Gedeselecteerde waarden groeperen in Overige in de vervolgkeuzelijst.
- Voor het uitfilteren van waarden heft u de selectie ervan op en kiest u Gedeselecteerde waarden uitsluiten in de vervolgkeuzelijst.
Tip Pas filters toe na transformaties. Transformaties negeren filters voor uitgesloten waarden.Histogram: diagram geeft de distributie van de waarden op voorkomen of rijtelling weer.
- Kies een bucketmethode met de vervolgkeuzelijst Bucketwaarden op.
-
Configureer algemene instellingen in het rechterdeelvenster.
- Kies een Algoritme dat Einstein Discovery moet gebruiken om het model mee te maken.
Algoritme Beschrijving GLM Standaard. Een gegeneraliseerd lineair model is een op regressie gebaseerd algoritme. GBM Gradient Boost Machine is een op een beslissingenstructuur gebaseerd algoritme voor machine learning. XGBoost XGBoost is een op een beslissingenstructuur gebaseerd algoritme voor machine learning. Willekeurige forest Willekeurige forest is een gecontroleerd leeralgoritme dat meerdere beslissingsstructuren, randomisering en andere optimaliseringstechnieken gebruikt. Model Tournament (Toernooi) U kunt ook Einstein Discovery alle vier de algoritmen laten uitvoeren en vervolgens het algoritme gebruiken dat het beste presteert. - U kunt desgewenst een selectie maken in de vervolgkeuzelijst Validatieoptie om aan te geven of u een validatieset wilt opgeven. Zie Algemene instellingen bewerken voor een model voor meer informatie.
- Kies een Algoritme dat Einstein Discovery moet gebruiken om het model mee te maken.
- Klik op Model maken.
