Usted está aquí:
Configurar variables de texto
Configure ajustes para variables de texto individuales en su modelo.
Ediciones necesarias

| Disponible en Salesforce Classic y Lightning Experience. |
| Disponible con CRM Analytics, que está disponible por un coste adicional en Enterprise Edition, Performance Edition y Unlimited Edition. Está disponible además en Developer Edition. |
| Permisos de usuario necesarios | |
|---|---|
| Para configurar campos de texto en un modelo: | Crear y actualizar modelos de Einstein Discovery |
-
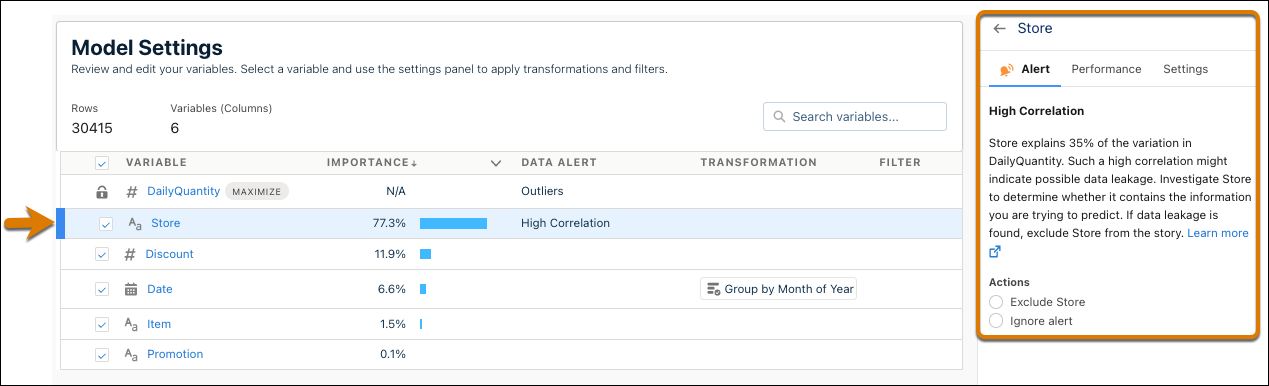
En la página Configuración de modelo, haga clic en una variable de texto. El panel de variables aparece.
-
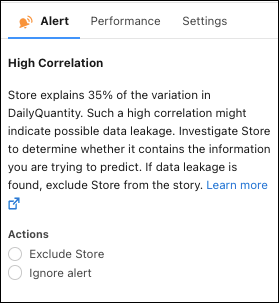
En la ficha Alertas, responda a cualquier sugerencia acerca de problemas de datos para este campo, como correlación más alta, predictores más sólidos o valores que faltan. Para obtener más información, consulte Gestionar alertas de calidad.
-
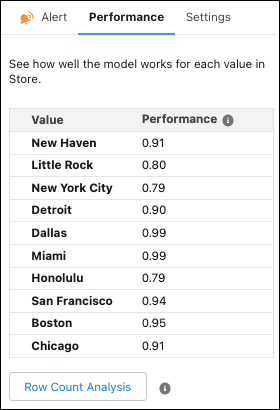
En la ficha Rendimiento, vea lo bien que funciona su modelo para cada valor en la variable seleccionada.
El rendimiento se muestra como una puntuación decimal, donde 1 es la precisión perfecta. Por ejemplo, en la variable Store, Miami tiene una puntuación de rendimiento de 0,99, y Honolulu una puntuación de 0,79. Entonces puede concluir que el modelo tiene un rendimiento mejor para el establecimiento de Miami que para el de Honolulu.
-
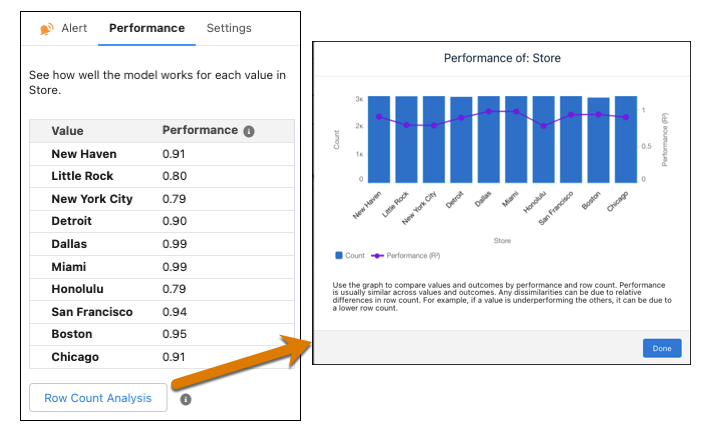
Opcionalmente, si utiliza un modelo de regresión o clasificación binaria, haga clic en Análisis de recuento de filas para ver una comparación detallada de los valores por rendimiento y recuento de filas.
-
Opcionalmente, si utiliza un modelo de clasificación de clases múltiples, consulte el rendimiento de cada valor por resultado.
- Para ampliar un valor para ver el rendimiento por resultado, haga clic en
 .
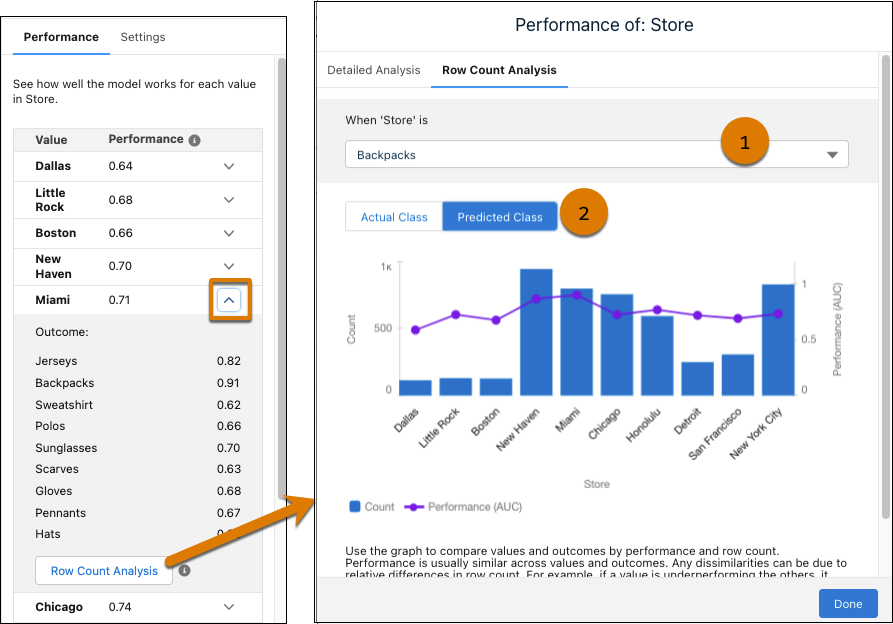
- Para ver una comparación gráfica de valores y resultados por rendimiento y recuento de filas, haga clic en Análisis de recuento de filas.
- Utilice el menú desplegable para seleccionar diferentes resultados (1). El gráfico se actualiza de acuerdo con el resultado seleccionado.
- Cambie entre Clase actual y Clase predicha (2). La Clase real agrupa datos basándose en el valor observado. La Clase predicha agrupa datos basándose en el valor predicho.
- Para ver una comparación gráfica de valores y resultados por rendimiento y recuento de filas, haga clic en Análisis de recuento de filas.
- Para ver un gráfico del rendimiento por valor y resultado, haga clic en Análisis detallado. Cuanto más oscuro sea el círculo, mejor será el rendimiento. Cuanto mayor sea el círculo, mayor será el recuento de filas.
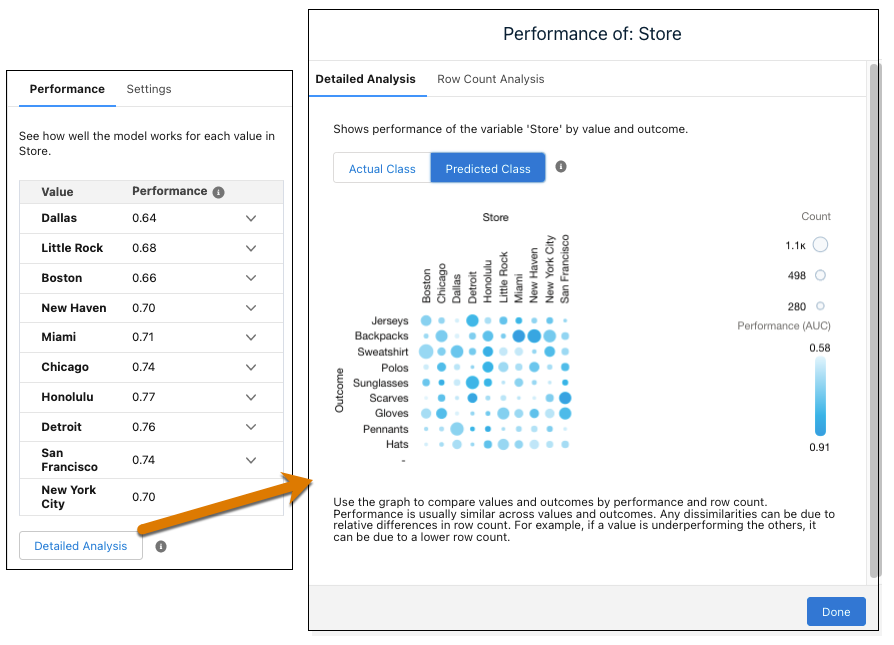
- Para ampliar un valor para ver el rendimiento por resultado, haga clic en
-
Opcionalmente, si utiliza un modelo de regresión o clasificación binaria, haga clic en Análisis de recuento de filas para ver una comparación detallada de los valores por rendimiento y recuento de filas.
-
En la ficha Ajustes, configure los siguientes ajustes.
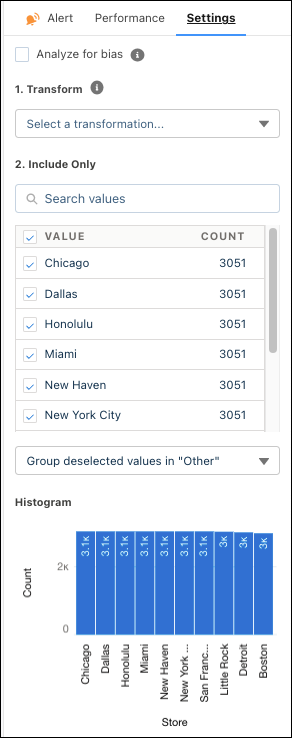
Configuración Descripción Analizar si hay sesgo Seleccione esta opción para excluir una variable del modelo de modo que no influya en predicciones y recomendaciones. Si se selecciona, Einstein Discovery muestra un icono de escudo junto al título de la perspectiva para recordarle que es una variable confidencial.
Esta opción le permite evaluar el impacto de la variable en el modelo. Einstein Discovery aún le notifica si muestra una correlación de 50% o superior en la variable de resultado del modelo.
Transformación Seleccione el método para transformar su texto:
- Coincidencia parcial para resolver variaciones de ortografía. Consulte Aplicar coincidencia parcial para categorizaciones más inteligentes.
- Detectar opinión para categorizar datos no estructurados. Consulte Detectar opinión en texto no estructurado.
- Agrupación de texto para depositar datos sin desglosar por palabras clave. Consulte Utilizar agrupación de texto para analizar datos no estructurados.
- Reemplace valores que faltan para rellenar valores que faltan. Consulte Imputar valores de texto que faltan.
Solo Incluir Seleccione los valores que desea incluir en el modelo. Dependiendo de las siguientes opciones, los valores excluidos se omiten en el análisis o se combinan en la categoría Otros. Histograma Un gráfico de barras muestra el número de valores que se producen entre valores. Los cambios entran en vigor tras crear el modelo.
- Aplicar coincidencia parcial para categorizaciones más inteligentes
La coincidencia parcial agrega uniformidad a variaciones de ortografía en variables, dando como resultado categorizaciones más inteligentes y mejores predicciones. Einstein Discovery transforma los datos en el tiempo de predicción, permitiéndole omitir la limpieza durante la preparación de los datos. - Detectar opinión en texto no estructurado
Procese datos no estructurados durante la creación de modelos y categorice opiniones como positivas, negativas o neutras. - Utilizar agrupación de texto para analizar datos no estructurados.
La agrupación de texto reduce los datos no estructurados a sus palabras clave principales y le permite revelar rápidamente perspectivas ocultas y mejorar la toma de decisiones. - Imputar valores de texto que faltan
Einstein Discovery le permite imputar valores de texto que faltan en su conjunto de datos. Active la imputación en una variable de texto, y Einstein Discovery sustituye automáticamente valores que faltan por datos derivados desde otro subconjunto de sus datos.
