設定文字變數
設定模型中的各個文字變數。
必要版本

備註 Einstein Discovery 情節現已為模型。我們希望在彈指之間就能夠將每一處的這個名稱更新,但在我們取代該名稱前,您還是會在一些地方看見先前的名稱。
| 適用於 Salesforce Classic 與 Lightning Experience。 |
| CRM Analytics 隨附 (以下版本需額外付費取得 CRM Analytics:Enterprise、Performance 與 Unlimited Edition)。亦適用於 Developer Edition。 |
| 需要的使用者權限 | |
|---|---|
| 若要設定模型中的文字欄位: | 建立及更新 Einstein Discovery 模型 |
-
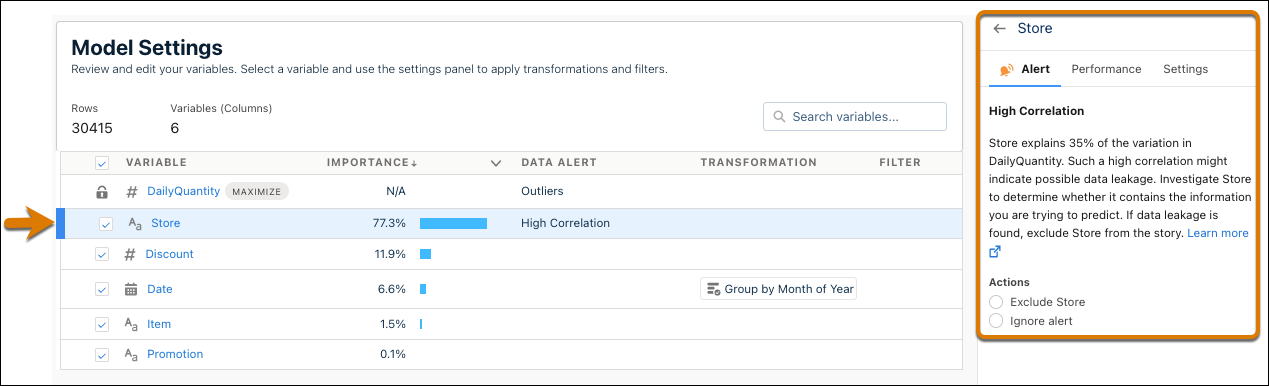
在「模型設定」頁面上,按一下文字變數。變數面板隨即顯示。
-
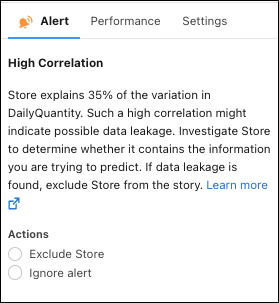
在「警示」索引標籤中,回應與此欄位資料問題 (例如高度關聯、最強預估因子或遺漏值) 相關的任何建議。如需詳細資訊,請參閱處理品質警示。
-
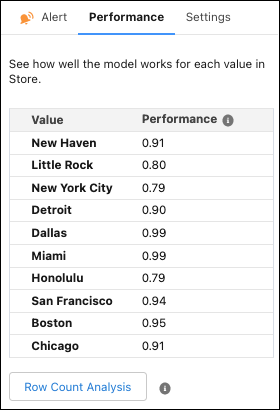
在「效能」索引標籤中,查看您的模組對所選變數中每個值的適用程度。
效能會顯示為小數點分數,其中 1 代表完美準確性。例如,在變數 Store 中,邁阿密的績效分數為 0.99,檀香山的績效分數為 0.79。然後,您可以總結模型對於邁阿密商店的績效比檀香山商店更佳。
-
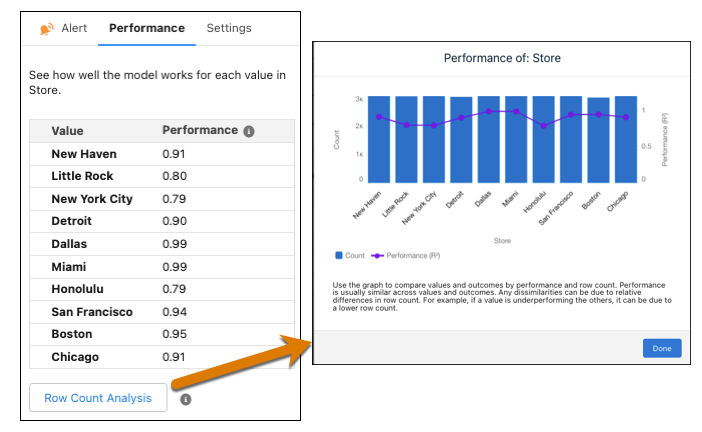
或者,如果使用二元分類或迴歸模型,請按一下「列數分析」,以依效能與列數查看值的詳細比較。
-
或者,如果使用多類別分類模型,則可以依成果查看每個值的效能。
- 若要展開值以依成果查看效能,請按一下
 。
- 若要依效能和列數查看值和成果的圖表比較,請按一下「列數分析」。
- 使用下拉式清單來選取不同的成果 (1)。圖表會根據所選成果更新。
- 在「實際類別」和「預估類別」之間切換 (2)。「實際類別」會根據觀察值將資料分組。「預估類別」會根據預估值將資料分組。
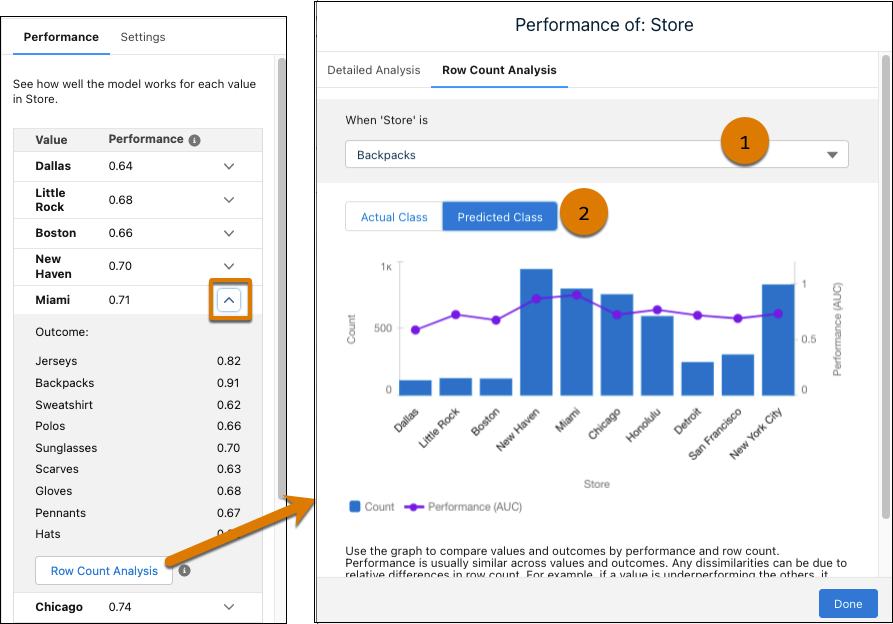
- 若要依效能和列數查看值和成果的圖表比較,請按一下「列數分析」。
- 若要依值和成果查看效能圖表,請按一下「詳細分析」。圓形顏色愈深,效能愈好。圓形愈大,列數愈高。
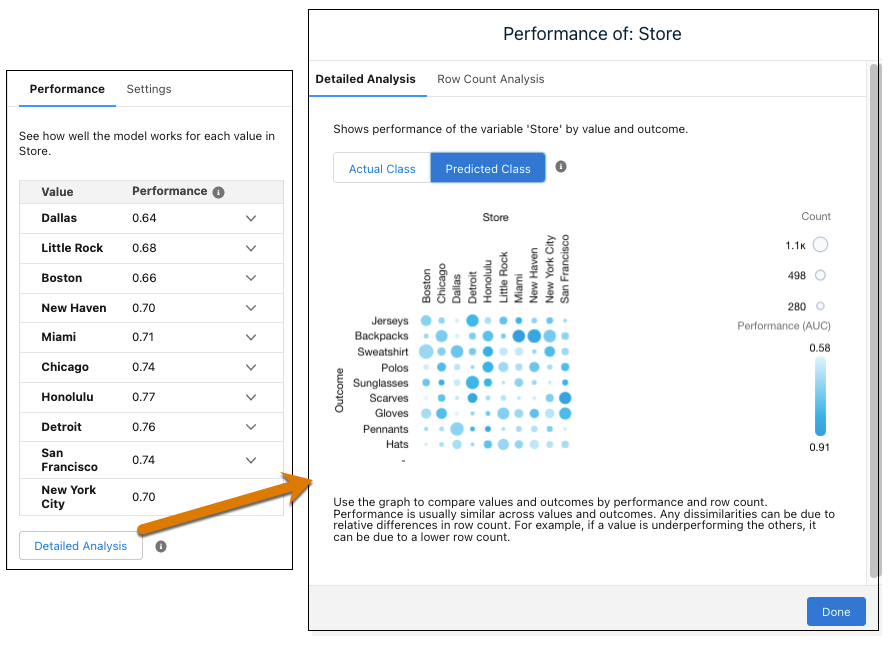
- 若要展開值以依成果查看效能,請按一下
-
或者,如果使用二元分類或迴歸模型,請按一下「列數分析」,以依效能與列數查看值的詳細比較。
-
在「設定」索引標籤上,進行下列設定。
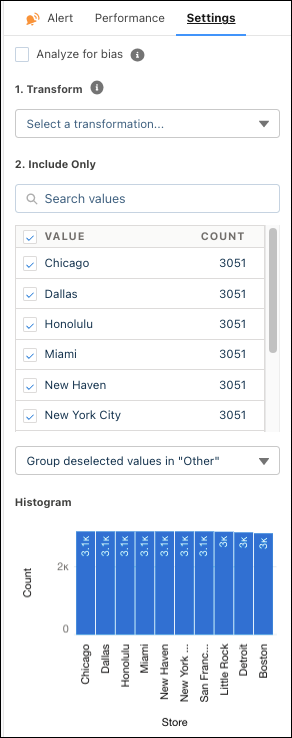
設定 描述 針對偏差進行分析 選取此選項可將變數從模型中排除,讓該變數不會影響預估與建議。若選取,則 Einstein Discovery 會在洞察的標題旁顯示盾牌圖示來提醒您這是敏感變數。
此選項可讓您評估和評估變數在模型中的影響。如果顯示與模型成果變數的相關性為 50% 或更高,Einstein Discovery 仍會通知您。
轉換 選取轉換文字的方法:
- 模糊比對以解決拼字變化。請參閱套用模糊比對以取得更明智的分類。
- 「偵測情感」以分類非結構化資料。請參閱偵測非結構化文字中的情感。
- 「文字叢集」可依關鍵字分類未叢集的資料。請參閱使用文字叢集分析非結構化資料。
- 「取代遺漏值」以填入遺漏值。請參閱填補遺漏文字值。
僅包含 選取您要在模型中包含的值。視下列選項而定,排除的值會從分析中省略,或合併至「其他」種類。 直方圖 長條圖圖表會顯示在整個值中發生的值數量。 變更會在您建立模型後生效。
- 套用模糊比對以取得更明智的分類
模糊比對可使變數中的拼字變化一致化,進而產生更智慧的分類方式和較佳的預估結果。Einstein Discovery 會在預估時間轉換資料,讓您在準備資料期間略過清理作業。 - 偵測非結構化文字中的情感
在模型建立期間處理非結構化資料,並將情感分類為正面、負面或中立。 - 使用文字叢集分析非結構化資料
文字叢集會將非結構化資料減少為其首要關鍵字,讓您能快速顯示隱藏的洞察並改善決策。 - 填補遺漏文字值
Einstein Discovery 可讓您填補資料集中遺漏的文字值。啟用文字變數的填補功能,Einstein Discovery 會自動以其他資料子集衍生的資料取代遺漏值。
此文章是否解決您的問題?
請讓我們知道,以便我們改進!
