詳細情報:
append 変換
append 変換は、複数のデータセットの行を 1 つのデータセットに統合します。

メモ データプレップレシピで行を追加するには、「追加ノード: さまざまなデータセットからの行の積み上げ」を参照してください。従来のデータプレップレシピでこれを行うには、「追加を使用したレシピの行の追加」を参照してください。
この変換を使用する場合は、次のルールに留意してください。
- この変換では、重複レコードは削除されません。
- すべての入力データセットの構造は同じである必要があります。つまり、対応する列は同じ順序で並び、名前とデータ型が同じである必要があります。

例
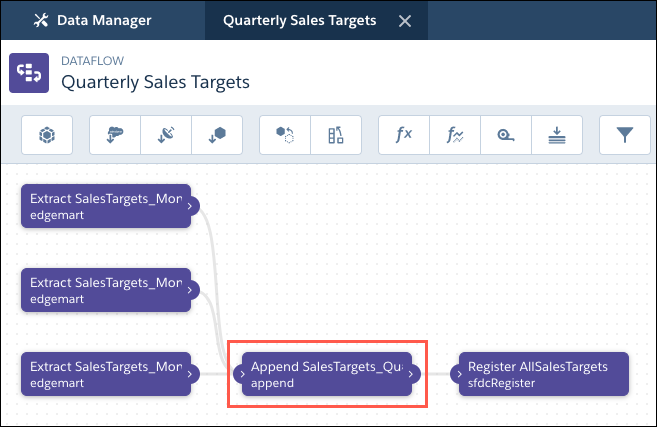
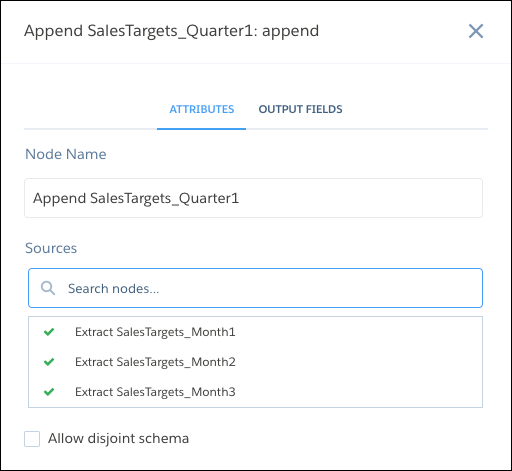
例を見てみましょう。毎月、その月の販売目標が含まれるデータセットを作成しています。すべての月の販売目標を全体的に把握する必要があります。これを行うには、次のデータフローを作成して既存のデータセットを 1 つのデータセットにマージします。
| データフロー | データフロー内の追加ノード |
|---|---|
|
|
JSON データフローを次に示します。
{
  "Extract SalesTargets_Month3": {
    "action": "edgemart",
    "parameters": {
      "alias": "SalesTargets_Month3"
    }
  },
  "Extract SalesTargets_Month2": {
    "action": "edgemart",
    "parameters": {
      "alias": "SalesTargets_Month2"
    }
  },
  "Extract SalesTargets_Month1": {
    "action": "edgemart",
    "parameters": {
      "alias": "SalesTargets_Month1"
    }
  },
  "Append SalesTargets_Quarter1": {
    "action": "append",
    "parameters": {
      "enableDisjointedSchemaMerge": false,
      "sources": [
        "Extract SalesTargets_Month1",
        "Extract SalesTargets_Month2",
        "Extract SalesTargets_Month3"
      ]
    }
  },
  "Register AllSalesTargets": {
    "action": "sfdcRegister",
    "parameters": {
      "name": "All Sales Targets",
      "alias": "AllSalesTargets",
      "source": "Append SalesTargets_Quarter1"
    }
  }
}
1 つのデータセットを作成したら、データ検索条件を使用して月別、四半期別、または年別で販売目標を分析できます。
メモ append 変換は重複する行を削除しません。
スキーマの異なるデータセットの追加
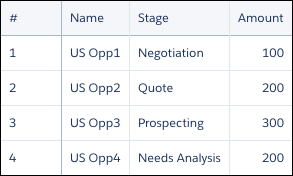
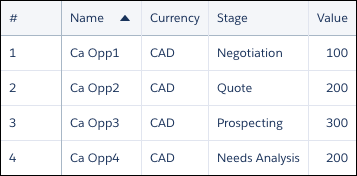
デフォルトでは、入力データセットの構造は同じである必要があります。つまり、対応する列は名前とデータ型が同じである必要があります。たとえば、カナダの商談を米国の商談に追加する必要があるとします。
| 米国のセールス | カナダのセールス |
|---|---|
|
|
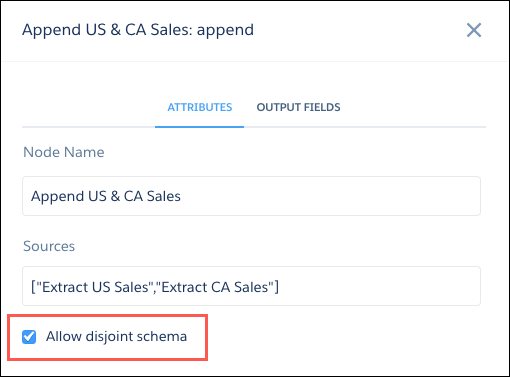
ここでは、列名が異なります。また、カナダのデータには [Currency (通貨)] 列が含まれます。データフローが失敗しないようにするには、データフローエディターで追加ノードの [ディスジョイントスキーマを許可] を選択します。データフロー JSON で作業している場合は、enableDisjointedSchemaMerge パラメーターを追加してその値を true に設定します。
| データフローエディター内の追加ノード | データフロー JSON 内の追加ノード |
|---|---|
|
|
データフローを実行すると、データフローが失敗することなくデータがマージされます。
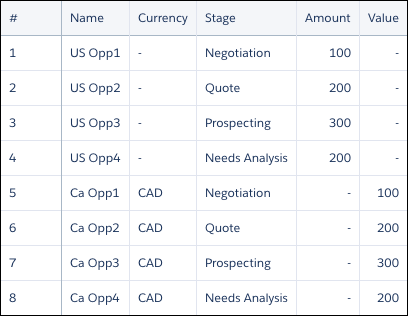
追加変換では、すべての列がデータセットに追加され、[Name (名前)] など、同じ名前を持つ列の値がマージされます。また、[通貨] 列など、以前にその列が含まれていなかった行には null 値が追加されます。
メモ データセット内の null 基準の処理を組織で有効にしていない場合、追加によって、マージ前に行に含まれていなかった列には 0 が追加されます。
- append パラメーター
データフロー JSON で append 変換を定義する場合は、アクション属性をappendに設定してパラメーターを指定します。
この記事で問題は解決されましたか?
ご意見をお待ちしております。
