breadcrumbDescription
Registrer sentiment-modelkort
I CRM Analytics bruger Registrer sentiment-transformationen modellen til at bestemme, om sentimentet for teksten er positivt, negativt eller neutralt. Brug dette modelkort til bedre at forstå modellen, hvordan den trænes, dens funktioner, dens tiltænkte brug og dens begrænsninger.
Registrer sentiment-modelkort
Få grundlæggende oplysninger om modellen Registrer sentiment. Denne tabel indeholder detaljer om den aktuelle model.
| Detalje | Beskrivelse |
|---|---|
| Navn for modeludvikler | CRM Analytics (CRM-analyser) |
| Modeldato | 2020-8-12 |
| Modelversion | 4 |
| Modeltype | Sentimentanalyse |
| Modelinput | Tekstkolonne (dimension) |
| Modeloutput | For hvert felt i en tekstkolonne (dimension) i en opskrift i Dataforberedelse returnerer modellen sentimentet: positive, negative eller neutrale. Modellen returnerer nul, når inputværdien er nul, og returnerer neutral, når inputværdien er en tom streng (''). |
| Licens | Registrer sentiment er tilgængelig for kunder med enhver CRM Analytics-brugerlicens. |
Mindre ændringer af modellen kan forekomme i hele frigivelsesperioden. Ændringer i større omfang kan forekomme og kommunikeres via produktbemærkninger.
Modeluddannelse
Vi trænede modellen Registrer sentiment baseret på GloVe-ordbogs- og uddannelsesdata. For at få kendskab til tekst benytter vi GloVe-ordbogen til at konvertere tekst fra uddannelsesdata til ord-vektorer og derefter identificere sentimentet baseret på den vurdering, der er knyttet til hver kommentar i uddannelsesdata.
Vi brugte følgende proces til at træne modellen.
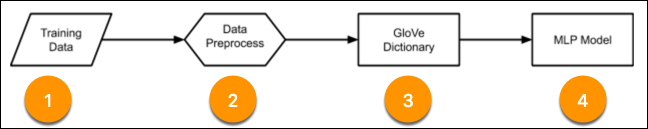
- Indsaml uddannelsesdata. Uddannelsesdata består af produktgennemgangskommentarer og deres vurderinger, som 4 stjerner ud af 5.
- Brug en forhåndsproces til at manipulere uddannelsesdata i det format, der kræves af GloVe.
- Kør uddannelsesdata gennem GloVe for at konvertere dem til to vektorer. Vi brugte Wikipedia 2014 + English Gigaword Fifth Edition GloVe-ordbogslisten til at konvertere hver streng til en vektor.
- Overfør vektorer og deres tilknyttede vurderinger gennem en MLP-neurale netværksmodel (Multilayer Perceptron) for at træne modellen til at forudsige tekstens sentiment.
Hvis du ønsker flere oplysninger om GloVe-ordbogslisten, kan du se dette website.
GloVe-ordbogen gøres tilgængelig under Public Domain Dedication and License v1.0, hvis fulde tekst kan findes på: http://opendatacommons.org/licenses/pddl/1.0/.
Anvendelsessituationer
Forstå de primære tilsigtede og anvendelsessituationer uden for området, der er knyttet til Registrer sentiment-modellen.
Den primære anvendelsessituation er at registrere sentimentet i ustruktureret tekst, der er videregivet til Registrer sentiment-transformationen i en opskrift i Dataforberedelse. Ustruktureret tekst kan inkludere kundeundersøgelser, produkt- og servicefeedback og ustruktureret kommunikation, f.eks. chatmeddelelser, tekstmeddelelser, mailkorrespondance og sociale medieindlæg.
Disse anvendelsessituationer er uden for omfanget:
- Registrer sentiment-transformationen kan ikke kaldes uden for opskrifter i Dataforberedelse.
- Inputteksten kan ikke tilsidesætte Salesforce-datacentre. Dataene skal være tilgængelige i Salesforce for at blive evalueret af Registrer sentiment-transformationen.
- Registrer sentiment understøtter ikke ikke-engelsk inputtekst. Den behandler ikke-engelsk tekst som engelsk og ignorerer billeder, herunder emoji.
Faktorer
Da vi havde overvejet deep-learning- og leksikonbaserede tilgange til sentimentanalyse, besluttede vi at bruge en hybrid af begge tilgange for at reducere bias i sentimentmodellen.
Vi valgte at træne modellen ved brug af offentligt tilgængelige datasæt med produktanmeldelser frem for andre datasæt på grund af dens relevans for forretningsanvendelsessituationer. Andre offentligt tilgængelige, navngivne datasæt, f.eks. filmanmeldelser eller opslag fra sociale medier er generelt ikke så relevante og kan forstyrre nøjagtigheden. Da sentimentmodellen trænes på specifikke datasæt, kan nøjagtigheden af sentimentet variere på basis af, hvor lignende dine data er til træningsdataene. Og fordi træningsdata aktuelt er på engelsk, understøtter sentimentmodellen kun engelsk tekst på dette tidspunkt.
Hvis du vil vide, hvor godt modellen fungerer med forskellige domæner af data, kan du se nærmere på nøjagtigheder og F1-scores. Når vi evaluerede modellen baseret på produktanmeldelser og svar fra kundeserviceundersøgelser, opnåede modellen sentimentnøjagtighed mellem 69.09%-83,12% og en F1-score fra 0,34 til 0,9. Da vi udførte partisk test, opnåede modellen 92,31% nøjagtighed og en F1-score på 0,9. Hvis du er nysgerrig efter, hvorfor resultaterne varierer, skyldes det, at hvert datadomæne kan have unikke udtryk, der ikke blev brugt til at træne modellen Registrer sentiment. Som resultat kan modellens nøjagtighed variere baseret på dataenes domæne.
Modellen trænes ved brug af 80 % af åbne tilgængelige produktgennemgangsdata, som består af ca. 100.000 vurderinger og anmeldelser. Sentimenterne for træningsdataene bestemmes på basis af vurderingerne. Højt bedømte kommentarer betragtes som positive. For at evaluere modellen sammenlignede vi de genererede sentimenter for de resterende 20 % af produktanmeldelserne i forhold til deres faktiske vurderinger. Vi evaluerede også modellen ved brug af private undersøgelsessvar.
Etiske overvejelser
Vi har taget yderligere mål og forholdsregler for at afhjælpe bias i forhold til udtryk, der repræsenterer kønsidentitet, seksuel orientering, religiøs tilknytning og etnicitet. Der er inkluderet 11 identitetsudtryk i denne begrænsning (atheister, queer, same sex, stepsemmer, homoseksuelt, feministisk, sort, hvid, heteroseksuelt, Islam, muslim og biseksuelt). Ved at bruge syntetiske data trænede vi modellen til altid at forudsige neutrale sentimenter for disse udtryk. Selvom teksten, der omgiver disse identitetsudtryk, kan ændre sentimentet, har disse udtryk alene et neutralt sentiment. Med introduktionen af hovedsageligt manuelt udvalgte data af høj kvalitet, kunne vi reducere bias for de angivne udtryk i et større omfang, uden at forringe modelydeevnen. Vi anerkender, at listen over identitetsudtryk, der er inkluderet i denne reduktion, ikke er komplet, og at der skal udføres fremtidigt arbejde, før listen bliver mere inkluderende for et bredere område af interessenter.
Modellen genererer typisk de korrekte sentimenter, men resultaterne kan variere på baggrund af dataene. Modellen behandler f.eks. muligvis ikke nye sprog, slang eller sarkasme korrekt. Den returnerer også uventede resultater for tekst uden sentiment, som f.eks. id'er, navneord, adresser og alfanumeriske værdier. Da nøjagtigheden kan variere, bør du overveje at foretage beslutninger baseret på tendenser i sentimentscores over tid i stedet for på scores på et bestemt tidspunkt.
Hvis du ønsker flere oplysninger om modelkortet Registrer sentiment, kan du se følgende ressourcer.
