Usted está aquí:
Tarjeta de modelo Detectar opinión
En CRM Analytics, la transformación Detectar opinión utiliza el modelo para determinar si la opinión del texto es positiva, negativa o neutra. Utilice esta tarjeta de modelo para comprender mejor el modelo, cómo está entrenado, sus funciones, su uso pensado y sus limitaciones.
Tarjeta de modelo Detectar opinión
Obtenga información básica acerca del modelo Detectar opinión. Esta tabla proporciona detalles acerca del modelo actual.
| Detalle | Descripción |
|---|---|
| Desarrollador de modelo | CRM Analytics |
| Fecha de modelo | 12/08/2020 |
| Versión de modelo | 4 |
| Tipo de modelo | Análisis de opiniones |
| Entrada de modelo | Columna de texto (dimensión) |
| Salida de modelo | Para cada campo en una columna de texto (dimensión) de una receta de Preparación de datos, el modelo devuelve la opinión: positiva, negativa o neutra. El modelo devuelve nulo si la entrada es nula y devuelve neutro cuando la entrada es una cadena vacía (''). |
| Licencia | Detectar opinión está disponible para clientes con cualquier licencia de usuario de CRM Analytics. |
Los cambios menores en el modelo se pueden producir en toda la versión. Los cambios importantes se pueden producir y se comunican a través de Notas de versión.
Entrenamiento de modelo
Entrenamos el modelo Detectar opinión basándose en el diccionario GloVe y datos de entrenamiento. Para aprender las opiniones de texto, utilizamos el diccionario GloVe para convertir texto desde los datos de entrenamiento en vectores de palabras, y luego identificamos la opinión en base a la clasificación asociada con cada comentario en los datos de entrenamiento.
Utilizamos el siguiente proceso para entrenar el modelo.
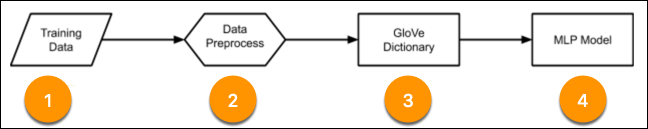
- Recopile los datos de entrenamiento. Los datos de entrenamiento consisten en comentarios de reseñas de productos y sus valoraciones, como 4 estrellas de 5.
- Utilice un proceso previo para enviar los datos de entrenamiento en el formato requerido por GloVe.
- Ejecute los datos de entrenamiento a través de GloVe para convertirlos en vectores. Utilizamos el diccionario GloVe de quinta edición de Gigaword en inglés + Wikipedia 2014 para convertir cada cadena en un vector.
- Pase los vectores y sus clasificaciones asociadas a través de un modelo de red neuronal Perceptrón multicapa (MLP) para entrenar el modelo para predecir la opinión de texto.
Para obtener más información acerca del diccionario GloVe, consulte este sitio web.
El diccionario GloVe está disponible bajo Licencia y dedicación de dominio público v1.0 cuyo texto completo se puede encontrar en: http://opendatacommons.org/licenses/pddl/1.0/.
Casos de uso
Comprenda los casos de uso pensados y fuera de ámbito principalmente asociados con el modelo Detectar opinión.
El caso de uso principal es detectar el opinión de texto no estructurado transmitido a la transformación Detectar opinión en una receta de Preparación de datos. El texto no estructurado puede incluir encuestas de clientes, comentarios de productos y servicios y comunicaciones no estructuradas, como mensajes de chat, mensajes de texto, correspondencia de correo electrónico y publicaciones de redes sociales.
Estos casos de uso están fuera del ámbito:
- La transformación Detectar opinión no se puede invocar fuera de recetas de Preparación de datos.
- El texto de entrada no puede omitir los centros de datos de Salesforce. Los datos deben estar disponibles en Salesforce para su evaluación por la transformación Detectar opinión.
- Detectar opinión no admite texto de entrada no en inglés. Procesa texto no en inglés como inglés e ignora imágenes, incluyendo emojis.
Factores
Tras considerar los enfoques de aprendizaje profundo y basado en léxico para el análisis de opiniones, decidimos utilizar un híbrido de ambos enfoques para mitigar el sesgo en el modelo de opiniones.
Elegimos entrenar al modelo utilizando conjuntos de datos de reseñas de producto etiquetados disponibles públicamente ante otros conjuntos de datos debido a su relevancia en casos de uso comercial. Otros conjuntos de datos etiquetados disponibles públicamente, como reseñas de películas o publicaciones de redes sociales,. no son generalmente tan relevantes y pueden dificultar la precisión. Dado que el modelo de opiniones está entrenado con conjuntos específicos de datos, la precisión de las opiniones puede variar según la similitud de sus datos con los datos de entrenamiento. Además, como los datos de entrenamiento actualmente están en inglés, el modelo Detectar opinión solo admite texto en inglés en estos momentos.
Para obtener información acerca de cuán bien funciona el modelo con diferentes dominios de datos, consulte las precisiones y las puntuaciones F1. Cuando se evaluó el modelo según las reseñas de productos y las respuestas de encuestas de servicio de clientes, el modelo obtuvo una precisión de opinión entre 69,09%-83,12% y una puntuación F1 de 0,34 a 0,9. Cuando realizaremos pruebas sesgadas, el modelo obtuvo 92,31% de precisión y una puntuación F1 de 0,9. Si tiene curiosidad por el motivo de la diferencia de los resultados, es porque cada dominio de datos puede tener términos exclusivos que no se utilizaron para entrenar el modelo Detectar opinión. Como resultado, la precisión del modelo puede variar basándose en el dominio de los datos.
El modelo se entrena utilizando el 80% de los datos de valoración de productos disponibles abiertamente, que consiste en cerca de 100.000 valoraciones y reseñas. Las opiniones de los datos de entrenamiento se determinan basándose en las valoraciones. Por ejemplo, los comentarios altamente valorados se consideran positivos. Para evaluar el modelo, comparamos las opiniones generadas del 20% restante de las reseñas del producto con sus valoraciones actuales. También evaluamos el modelo utilizando respuestas de encuestas propias.
Consideraciones éticas
Tomamos precauciones y mediciones adicionales para corregir el sesgo ante términos representando identidad de género, orientación sexual, confesión religiosa y raza. Se incluyeron once términos de identidad en esta mitigación (ateo, marica, gay, lesbiana, homosexual, feminista, negro, blanco, heterosexual, musulmán y bisexual). Empleando dados sintéticos, entrenemos el modelo para predecir siempre opiniones neutras para estos términos. Aunque el texto que rodea estos términos de identidad puede cambiar la opinión, estos términos solos tienen una opinión neutra. Con la introducción de datos de gran volumen, mostrándoles el nivel de control, y con esta capacidad, se pudieron reducir los sesgos para los términos especificados a gran escala sin dañar el rendimiento del modelo. Reconocemos que la lista de términos de identidad incluidos en esta mitigación no es exhaustiva y que el trabajo futuro debe llevarse a cabo para ampliar la lista para ser más inclusivo de una gama más amplia de partes interesadas.
Habitualmente, la transformación genera las opiniones correctas, pero los resultados pueden variar basándose en los datos. Por ejemplo, el modelo no procesa con precisión nuevo lenguaje, jerga o sarcasmo. También devuelve resultados inesperados para texto sin opinión, como Id., sustantivos, direcciones y valores alfanuméricos. Como la precisión puede variar, considere tomar decisiones basándose en puntuaciones de opinión con el tiempo en vez de puntuaciones en un momento concreto en el tiempo.
Para obtener más detalles acerca del tarjeta de modelo Detectar opinión, consulte los siguientes recursos.
