U bent hier:
Modelkaart Gevoel signaleren
De transformatie Gevoel signaleren gebruikt in CRM Analytics het model om te bepalen of het gevoel van de tekst positief, negatief of neutraal is. Gebruik deze modelkaart voor een beter inzicht in het model, de manier waarop het wordt getraind, de mogelijkheden ervan, het beoogde gebruik ervan en de beperkingen ervan.
Modelkaart Gevoel signaleren
Verkrijg basisinformatie over het model Gevoel signaleren. Deze tabel bevat details over het huidige model.
| Details | Beschrijving |
|---|---|
| Modelontwikkelaar | CRM Analytics |
| Datum van model | 12 augustus 2020 |
| Modelversie | 4 |
| Modeltype | Gevoelsanalyse |
| Invoer van model | Kolom Tekst (dimensie) |
| Uitvoer van model | Voor elk veld in een tekstkolom van een recept van Gegevensvoorbereiding retourneert het model het gevoel (sentiment): positief, negatief of neutraal. Het model retourneert null als de invoer null is, and retourneert neutraal als de invoer bestaat uit een lege tekenreeks (''). |
| Licentie | Gevoel signaleren is beschikbaar voor klanten met een CRM Analytics-gebruikerslicentie. |
Kleine wijzigingen aan het model kunnen zich voordoen in de gehele release. Er kunnen belangrijke wijzigingen optreden en die worden gecommuniceerd via Opmerkingen bij deze release.
Modeltraining
We hebben het model Gevoel signaleren getraind op basis van de GloVe-woordenlijst- en trainingsgegevens. Om meer te weten over gevoelens in tekst hebben we de woordenlijst van GloVe gebruikt om tekst uit de trainingsgegevens te converteren naar woordvectoren hebben vervolgens het gevoel geïdentificeerd op basis van de beoordeling die is gekoppeld aan elke opmerking in de trainingsgegevens.
We hebben het volgende proces gebruikt om het model te trainen.
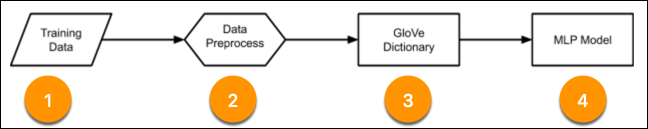
- Verzamel de trainingsgegevens. De trainingsgegevens bestaan uit opmerkingen bij de productbeoordeling en hun scores (beoordelingen), zoals 4 van 5 sterren.
- Gebruik een pre-process om de trainingsgegevens om te vormen naar de notatie die door GloVe is vereist.
- Voer de trainingsgegevens uit via GloVe om ze te converteren naar vectoren. We hebben de Wikipedia 2014 + English Gigaword Fifth Edition GloVe-woordenlijst gebruikt om elke tekenreeks te converteren naar een vector.
- Geef de vectoren en hun gekoppelde scores (beoordelingen) in middels een Multilayer Perceptron (MLP) neuraal-netwerkmodel om het model te trainen om het gevoel van de tekst te voorspellen.
Zie deze website voor meer informatie over de GloVe-woordenlijst.
De woordenlijst van GloVe wordt beschikbaar gesteld volgens het domein Public Domain Dedication and License v1.0 (versie 1.0), waarvan u de volledige tekst vindt op: http://opendatacommons.org/licenses/pddl/1.0/.
Gebruikscases
Zorg voor inzicht in de primaire beoogde en buiten bereik vallende gebruikscases die zijn gekoppeld aan het model Gevoel signaleren.
De primaire gebruikscase is het detecteren van het gevoel van ongestructureerde tekst die wordt doorgegeven aan de transformatie Gevoel signaleren in een Gegevensvoorbereiding-recept. Niet-gestructureerde tekst kan klantenenquêtes, feedback over producten en services, en niet-gestructureerde communicatie, zoals chatberichten, tekstberichten, e-mailcorrespondentie en posts op sociale media, omvatten.
Deze gebruikscases vallen buiten het bereik:
- De transformatie Gevoel signaleren kan niet worden aangeroepen buiten Gegevensvoorbereiding-recepten.
- De invoertekst kan Salesforce-gegevenscentra niet omzeilen. De gegevens moeten beschikbaar zijn in Salesforce om te kunnen worden geëvalueerd door de transformatie Gevoel signaleren.
- Gevoel signaleren ondersteunt geen invoertekst die niet in het Engels is. Niet-Engelse tekst wordt verwerkt als Engels en afbeeldingen worden genegeerd, waaronder ook emoji's.
Factoren
Nadat we eerst de deep-learning- en op lexicon gebaseerde benaderingen voor de analyse van gevoel (sentiment) hebben overwogen, hebben we besloten om een hybride vorm van beide benaderingen te gebruiken om de vertekening ("bias") in het model te verhelpen.
We hebben ervoor gekozen om het model te trainen met behulp van openbaar beschikbare, gelabelde gegevenssets voor productbeoordeling, in plaats van andere gegevenssets te gebruiken vanwege de relevantie ervan voor zakelijke gebruikscases. Andere openbaar beschikbare, gelabelde gegevenssets, zoals reviews van films of posts op sociale media, zijn over het algemeen niet zo relevant en kunnen de nauwkeurigheid negatief beïnvloeden. Omdat het gevoelsmodel (sentimentmodel) wordt getraind aan de hand van specifieke sets gegevens, kan de nauwkeurigheid van het gevoel variëren op basis van de mate waarin uw gegevens gelijk zijn aan de trainingsgegevens. Ook omdat de trainingsgegevens momenteel in het Engels zijn, ondersteunt het model Gevoel signaleren alleen Engelse tekst op dit moment.
Bekijk voor de informatie over de mate waarin het model werkt met verschillende domeinen van gegevens, de nauwkeurigheids- en F1-scores. Toen we het model evalueerden op basis van productbeoordelingen en responsen op enquêtes van de klantenservice, behaalde het model een nauwkeurigheidsscore voor gevoel van 69,09%--83,12% en een F1-score van 0,34 tot 0,9. Bij de uitvoering van testen op vertekening ("bias") behaalde het een nauwkeurigheid van 92,31% en een F1-score van 0,9. Als u zich afvraagt waarom de resultaten variëren, komt dit omdat in elk gegevensdomein unieke termen kunnen voorkomen, die niet zijn gebruikt voor het trainen van het model Gevoel signaleren. Daarom kan de nauwkeurigheid van het model dus variëren op basis van het domein van de gegevens.
Het model wordt getraind met behulp van 80% van de openlijk beschikbare productbeoordelingsgegevens, die bestaan uit ongeveer 100.000 scoreaanduidingen en beoordelingen. De gevoelens van de trainingsgegevens worden bepaald op basis van de scoreaanduidingen en beoordelingen. Zo worden goedkeurende opmerkingen als positief beschouwd. Voor het evalueren van het model hebben we de gegenereerde gevoelens van de resterende 20% van de productbeoordelingen vergeleken met de feitelijke scoreaanduidingen. We hebben het model ook geëvalueerd aan de hand van eigen enquête-responsen.
Ethische overwegingen
We hebben extra maatregelen en voorzorgsmaatregelen genomen ter correctie van vertekening ("bias") ten aanzien van termen die betrekking hebben op identiteit aangaande gender/geslacht, seksuele geaardheid, religieuze binding en etniciteit/ras. In deze aanpassing zijn aanvullende identiteitstermen (in de vorm van zelfstandige naamwoorden en bijvoeglijke naamwoorden) opgenomen (atheïst(isch), queer, gay, lesbisch/lesbienne, homo(seksueel), feminist(e)/feministisch, black/zwart, white/wit, hetero(seksueel), islam(iet), moslim en bi(seksueel)). Met behulp van synthische gegevens hebben we het model getraind om altijd neutrale gevoelens bij, over of voor deze termen te voorspellen. Hoewel tekst aangaande deze identiteitstermen het gevoel kan veranderen, hebben deze termen op zich een neutrale waarde c.q. neutraal gevoel. Met de introductie van overwegend handmatig samengestelde gegevens van hoge kwaliteit hebben we de vertekening voor de opgegeven termen kunnen verminderen zonder daarbij de prestaties van het model negatief te beïnvloeden. We erkennen dat de lijst van identiteitstermen die zijn opgenomen in deze aanpassing, niet volledig is, en dat er toekomstig werk moet worden verricht om de lijst dusdanig uit te breiden dat er een bredere groep belanghebbenden wordt onderkend.
Het model genereert doorgaans de juiste gevoelens, maar de resultaten kunnen wel variëren naargelang de gegevens. Het model verwerkt bijvoorbeeld mogelijk niet juist aspecten als nieuwe taal, jargon of sarcasme. Het retourneert ook onverwachte resultaten voor tekst zonder sentiment, zoals ID's, zelfstandige naamwoorden, adressen en alfanumerieke waarden. Omdat de nauwkeurigheid kan variëren, kunt u overwegen beslissingen te nemen op basis van trends in scores over tijd, in plaats van op basis van scores op een bepaald moment in de tijd.
Raadpleeg de volgende resources voor meer details over de modelkaart Gevoel signaleren.
