breadcrumbDescription
Delte dimensioner i Tableau-semantik
Analyser og sammenlign data på tværs af flere faktatabeller ved at forbinde dem gennem de samme dimensionstabeller. Opbyg komplekse, forretningsrelevante analyser på en ren og pålidelig måde ved at undgå dubletrelationer og eliminere cyklusser i din semantiske model.
I de fleste datasæt sporer forskellige forretningsdomæner deres egne begivenheder separat: Salg sporer transaktioner, Marketing sporer kampagner, Lager sporer lagerniveauer osv. Hver af disse forretningsprocesser vises som en faktatabel, der indeholder de kernemetrikker og transaktionsdata, der er relevante for det pågældende domæne.
For at gøre disse data meningsfulde, opretter hver faktatabel forbindelse til en eller flere dimensionstabeller, f.eks. Produkter, Datoer, Kampagner, Kunder eller Leverandører. Dimensioner beskriver fakta og tillader brugere at gruppere, filtrere eller aggregere dem (f.eks. efter dato, efter produktkategori, efter kundesegment).
Ofte deler forskellige faktatabeller de samme dimensioner. F.eks. er både Marketing og Salg relateret til Produkter og Datoer.
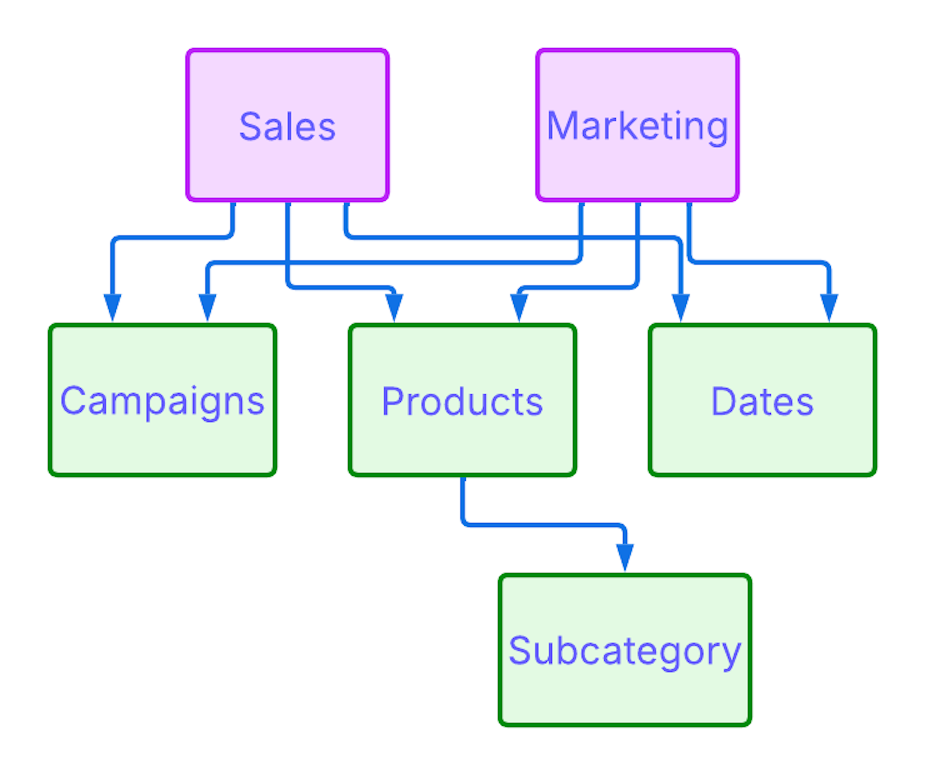
Når faktatabeller er relateret til en delt dimension, kan din organisation justere dataene og analysere værdierne sammen, så du kan:
- Sammenlign kampagneomkostninger fra Marketing og omsætning fra Salg efter produkt
- Opdel lagerniveauer og salgspræstation efter leverandør eller kunde
- Analyser kundesupportaktivitet sammen med købs- og returadfærd.
Sådanne forespørgsler strækker sig over forskellige faktatabeller, mens de delte dimensioner giver de forbindelsespunkter, der giver dig mulighed for at samle disse fakta og udforske dem side om side.
For at underbygge dette i den semantiske model introducerer vi begrebet delt tabeller. Når en dimensionstabel er markeret som delt, ved systemet, at den kan bruges til at tilslutte flere faktatabeller sikkert. Dette aktiverer ren, cyklusfri multi-faktanalyse og sikrer, at den semantiske model kan fortolke og eksekvere forespørgsler på tværs af domæner korrekt.
Relaterede i modsætning til ikke-relaterede tabeller
Et andet nøglebegreb i delte tabeller er forskellen mellem relaterede og ikke-relaterede tabeller.
To tabeller betragtes som relateret, når de er direkte forbundet af en defineret relation. Forespørgsler mellem relaterede tabeller fungerer som forventet: systemet bruger den definerede sti til at forbinde dem.
Hvis to tabeller ikke er helt relateret – hvilket betyder, at de ikke har nogen direkte eller delt forbindelse – kan systemet ikke bestemme, hvordan deres data skal kombineres, og forespørgslen mislykkes.
I nogle situationer er tabeller kun forbundet gennem en delt dimension. Hvis du forespørger på felter fra begge faktatabeller uden at inkludere et felt fra den delte tabel, og felterne ikke er aggregeret, udfører systemet en krydssammenføjning. Dette betyder, at hver række fra en faktatabel kombineres med hver række fra den anden, da der ikke er nogen delt nøgle til at justere dem.
Hvis f.eks. Salg og Marketing begge er linket til en delt tabel Produkter, og du forespørger på [Salg] [Salgsmængde] og [Marketing] [Forbrug] uden [Produkter] [Produktnavn], kombinerer systemet ganske enkelt alle salgsrækker med alle marketingrækker.
For at undgå dette skal forespørgslen indeholde et felt fra den delte tabel, f.eks. Produkt eller Dato, der fungerer som forbindelsesnøglen og giver en delt akse til gruppering og aggregering af værdier på tværs af de to fakta.
Delte dimensioner gør det muligt at analysere data fra tabeller, der ellers ville være isolerede, men kun når de bruges korrekt i forespørgslen.
Faktatræer og deres struktur
Et faktatræ er en gruppe af tabeller, der hører til det samme forretningsområde og er forbundet med hinanden. Det inkluderer sædvanligvis en eller flere faktatabeller sammen med dimensionstabeller.
Denne struktur er ikke kun et modelkoncept – det er noget, som systemet opbygger automatisk, når du kører en forespørgsel. Faktatræer er den måde, hvorpå det semantiske lag organiserer tabeller internt for at evaluere delte dimensioner korrekt.
I eksempeldiagrammet ovenfor er Marketing en faktatabel, der er tilsluttet til delte tabeller Produkter og Datoer. Dette danner dets faktatræ. Salg er en anden faktatabel, der opretter forbindelse til de samme delte dimensioner og danner et separat faktatræ. Denne struktur gør det muligt for systemet at forstå, hvordan hvert træ fungerer uafhængigt, mens du stadig aktiverer krydstræanalyser gennem delte dimensioner.
Faktatræer skal forblive cyklusfri. Cyklusser introducerer tvetydighed: Hvis systemet kan nå den samme tabel gennem mere end en sti, ved det muligvis ikke, hvilken der skal følges, eller hvordan du anvender filtre og aggregeringer korrekt. Af denne årsag er oprettelse af en ny relation, der introducerer en cyklus - f.eks. tilslutning af Marketing direkte til Underkategori (som allerede er tilgængelig via Produkt) - ikke tilladt.
Hvordan delte dimensioner påvirker forespørgsler
Delte dimensioner hjælper ikke kun med at strukturere din semantiske model – de styrer også, hvordan forespørgsler optræder på kørselstidspunktet, hvilket sikrer nøjagtige resultater og ensartet logik.
Lad os antage, at du analyserer, hvordan Marketingforbrug er relateret til Salgsmængde. Disse to mål kommer fra forskellige faktatabeller: Marketing og Salg. I sig selv kan de ikke justeres meningsfuldt, da der ikke er nogen delt kontekst, som de kan grupperes efter. Hvis du blot trækker begge felter ind i en forespørgsel uden at bruge en delt reference, kan systemet ikke matche rækkerne og kan returnere misvisende resultater eller endda mislykkes.
Men når du henter to delte dimensioner, f.eks. Produkt og Dato, ændres situationen. Med disse på plads kan du spørge: "For hvert produkt og hver måned, hvor meget brugte vi på marketing, og hvor mange enheder blev der solgt?"
Da Salg og Marketing begge er forbundet med Produkter og Datoer (delte tabeller), kan systemet nu justere begge mål korrekt – efter produkt, efter måned – og returnere meningsfulde, aggregerede resultater:
| Produkt | Måned | Marketingforbrug | Salgsmængde |
|---|---|---|---|
| Bike | Jan 2024 | 5.000 | 12 |
| Bike | Feb 2024 | nul | 8 |
| Bil | Jan 2024 | 10,320 | 22 |
| Bil | Feb 2024 | 5.000 | 10 |
Filtreringsadfærd
Filtre anvendes på en måde, der undgår at ændre data fra ikke-relaterede tabeller.
- Når du anvender et filter på et faktaspecifikt felt, f.eks. Marketingtype, filtrerer det kun denne faktatabel – ikke andre fakta eller delte dimensioner.
- Når du anvender et filter på en delt dimension, f.eks. Produktnavn eller Dato, gælder det for alle faktatabeller, der er tilsluttet.
Denne adfærd forhindrer filtre i at fjerne ikke-relaterede registreringer. Hvis du f.eks. vælger Online i filteret Marketingstype, er det kun Marketingforbrug, der bliver opdateret -- Salgsmængde forbliver upåvirket.
Faktatræer skal forblive cyklusfri. Cyklusser introducerer tvetydighed: Hvis systemet kan nå den samme tabel gennem mere end en sti, ved det muligvis ikke, hvilken der skal følges, eller hvordan du anvender filtre og aggregeringer korrekt. Af denne årsag er oprettelse af en ny relation, der introducerer en cyklus - f.eks. tilslutning af Marketing direkte til Underkategori (som allerede er tilgængelig via Produkt) - ikke tilladt.
Beregnede felter og begrænsning af faktatræ
Beregnede felter skal respektere faktatrægrænser. Hvis du opretter et beregnet felt på rækkeniveau, f.eks.:
Hvis [Support].[Prioritet] <= 1 DA "Høj" ANDER "Lav"
-- dette felt er gyldigt, så længe det forbliver i det samme faktatræ (understøt i dette tilfælde). Du kan bruge den til at analysere mønstre eller filtrere supportrelateret aktivitet op mod dimensioner som Kunde eller Produkt (hvis disse dimensioner deles), og alt fungerer som forventet.
Men hvis du forsøger at oprette et beregnet felt, der strækker sig over flere faktatabeller, f.eks.:
[Lager].[Mængde] + [Salg].[Salgsmængde]
-- platformen opretter en fejl. Det forsøger at kombinere data på rækkeniveau fra to forskellige faktatræer, og systemet kan ikke løse et fælles detaljeniveau for dette udtryk. Hvert faktatræ har sin egen uafhængige detaljer og filtreringskontekst.
Hvis du vil opnå gyldige krydsfaktaregistreringer, skal du aggregere hver fakta uafhængigt og derefter kombinere disse aggregeringer på visningsniveauet:
SUM([Inventory].[Quantity]) + SUM([Sales].[Sales Quantity])
Dette udtryk er tilladt, fordi begge mål aggregeres, før de kombineres, og aggregeringen omfatter produktniveauet, eller hvad end dimensionen er i visningen.
Begrænsninger for delte dimensioner og faktatræer
- Faktatabeller skal forblive afbrudt fra hinanden. De kan ikke sammenføjes direkte. Enhver forbindelse mellem dem skal kun forekomme gennem delte dimensionstabeller.
- Beregnede felter på rækkeniveau – uanset om det er dimensioner eller mål – skal være fuldt indeholdt i et enkelt faktatræ.
- Du kan ikke tilslutte en delt tabel til en anden delt tabel og derefter til en faktatabel. Med andre ord kan der kun findes en delt tabel i forbindelsestien mellem enhver faktatabel og dens dimensioner. Hvis f.eks. Produkter er en delt tabel, der er forbundet med Datoer (en anden delt tabel), og derefter begge forbinder til Salg, understøttes denne struktur ikke.
- Når du filtrerer felter fra flere faktatræer i den samme forespørgsel, skal disse filtre kombineres ved brug af en OG betingelse, ikke ELLER.
- Opret en ny delt tabel
Brug delte tabeller til at linke flere faktatabeller gennem en fælles dimension for at sammenligne registreringer på tværs af forskellige tabeller. Dette bevarer din datamodel ren og utvetydig og sikrer, at filtre fungerer korrekt på tværs af forskellige datasæt.
