U bent hier:
Gedeelde dimensies in Tableau-semantiek
Analyseer en vergelijk gegevens over meerdere feittabellen door ze te verbinden via dezelfde dimensietabellen. Stel complexe, bedrijfsrelevante analyses samen op een schone en betrouwbare manier, vermijd dubbele relaties en elimineer cycli in uw semantische model.
In de meeste gegevenssets houden verschillende bedrijfsdomeinen hun eigen events afzonderlijk bij: Verkoop houdt transacties bij, Marketing houdt campagnes bij, Voorraad houdt voorraadniveaus bij, enzovoort. Elk van deze bedrijfsprocessen wordt weergegeven als een feittabel, die de kernmeetgegevens en transactiegegevens bevat die relevant zijn voor dat domein.
Om deze gegevens betekenisvol te maken, verbindt elke feittabel met een of meer dimensietabellen, zoals Producten, Datums, Campagnes, Klanten of Leveranciers. Dimensies beschrijven de feiten en laten gebruikers deze groeperen, filteren of aggregeren (bijvoorbeeld op datum, op productcategorie, op klantsegment).
Vaak hebben verschillende feittabellen dezelfde dimensies. Zo zijn zowel Marketing als Verkoop gerelateerd aan Producten en Datums.
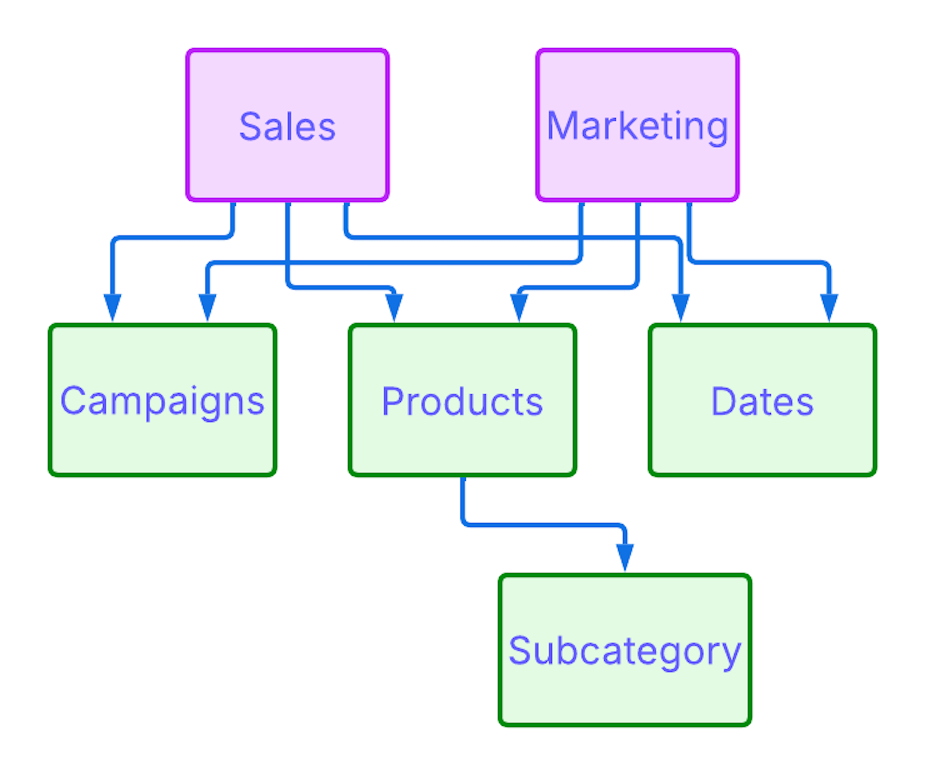
Wanneer feittabellen zijn gerelateerd aan een gedeelde dimensie, kan uw organisatie de gegevens uitlijnen en de waarden samen analyseren, waardoor u het volgende kunt doen:
- Campagnekosten van Marketing vergelijken met omzet van Verkoop op product
- Voorraadniveaus en verkoopprestaties opsplitsen op leverancier of klant
- Analyseer klantenondersteuningsactiviteit naast aankoop- en retourgedrag.
Dergelijke query's bestrijken verschillende feittabellen, terwijl de gedeelde dimensies de verbindingspunten bieden waarmee u deze feiten kunt samenbrengen en naast elkaar kunt verkennen.
Om dit te ondersteunen in het semantische model introduceren we het concept van gedeelde tabellen. Wanneer een dimensietabel is gemarkeerd als gedeeld, weet het systeem dat deze kan worden gebruikt om meerdere feittabellen veilig te verbinden. Dit maakt een zuivere, cyclusvrije analyse van meerdere feiten mogelijk en zorgt ervoor dat het semantische model query's tussen domeinen correct kan interpreteren en uitvoeren.
Gerelateerde versus niet-gerelateerde tabellen
Een extra sleutelbegrip in gedeelde tabellen is het verschil tussen gerelateerde en niet-gerelateerde tabellen.
Twee tabellen worden als gerelateerd beschouwd wanneer ze rechtstreeks zijn verbonden door een gedefinieerde relatie. Query's tussen gerelateerde tabellen werken zoals verwacht: het systeem gebruikt het gedefinieerde pad om ze samen te voegen.
Als twee tabellen volledig niet aan elkaar zijn gerelateerd (d.w.z. dat ze geen directe of gedeelde verbinding hebben), kan het systeem niet bepalen hoe de gegevens moeten worden gecombineerd, waardoor de query mislukt.
In sommige gevallen zijn tabellen alleen verbonden via een gedeelde dimensie. Als u een query uitvoert op velden uit beide feittabellen zonder een veld uit de gedeelde tabel op te nemen en de velden niet zijn geaggregeerd, voert het systeem een kruisjoin uit. Dit betekent dat elke rij uit de ene feittabel wordt gecombineerd met elke rij uit de andere, aangezien er geen gedeelde sleutel is om deze uit te lijnen.
Als bijvoorbeeld Verkoop en Marketing beide zijn gekoppeld aan een gedeelde tabel Producten en u een query uitvoert op [Verkoop].[Verkoophoeveelheid] en [Marketing].[Uitgeven] zonder [Producten].[Productnaam], combineert het systeem gewoon alle rijen Verkoop met alle rijen Marketing.
Om dit te voorkomen moet de query een veld uit de gedeelde tabel bevatten, zoals Product of Datum, dat als joinsleutel fungeert en een gedeelde as biedt voor het groeperen en aggregeren van waarden over de twee feiten.
Gedeelde dimensies maken het mogelijk om gegevens te analyseren uit tabellen die anders geïsoleerd zouden zijn -- maar alleen bij correct gebruik binnen de query.
Feitenbomen en hun structuur
Een feitenstructuur is een groep tabellen die tot hetzelfde bedrijfsgebied behoren en met elkaar zijn verbonden. Het omvat doorgaans een of meer feittabellen, samen met dimensietabellen.
Deze structuur is niet alleen een modelleringsconcept, maar wordt automatisch samengesteld wanneer u een query uitvoert. Feitenstructuren zijn de manier waarop de semantische laag tabellen intern ordent om gedeelde dimensies correct te evalueren.
In het bovenstaande voorbeelddiagram is Marketing een feittabel die is verbonden met gedeelde tabellen Producten en Datums. Dit vormt de feitenstructuur ervan. Sales is een andere feittabel die verbinding maakt met dezelfde gedeelde dimensies, waardoor een afzonderlijke feitstructuur wordt gevormd. Dankzij deze structuur kan het systeem inzicht krijgen in de manier waarop elke boom onafhankelijk werkt, terwijl er toch cross-tree analyse mogelijk is via gedeelde dimensies.
Feitenbomen moeten cyclusvrij blijven. Cycli introduceren ambiguïteit: als het systeem dezelfde tabel kan bereiken via meer dan één traject, weet het mogelijk niet welke het moet volgen of hoe het filters en aggregaties correct moet toepassen. Om deze reden is het maken van een nieuwe relatie die een cyclus introduceert -- zoals het rechtstreeks verbinden van Marketing met Subcategorie (die al bereikbaar is via Product) -- niet toegestaan.
Hoe gedeelde dimensies van invloed zijn op query's
Gedeelde dimensies helpen niet alleen bij het structureren van uw semantische model, ze bepalen ook hoe query's werken tijdens run-time, wat zorgt voor nauwkeurige resultaten en consistente logica.
Stel dat u analyseert hoe marketinguitgaven zich verhouden tot verkoophoeveelheid. Deze twee meeteenheden komen uit verschillende feittabellen: Marketing en verkoop. Op zichzelf kunnen ze niet zinvol worden uitgelijnd, omdat er geen gedeelde context is om ze op te groeperen. Als u beide velden gewoon naar een query sleept zonder een gedeelde verwijzing te gebruiken, kan het systeem de rijen niet vergelijken en kan het misleidende resultaten opleveren of zelfs mislukken.
Zodra u echter twee gedeelde dimensies inbrengt, zoals Product en Datum, verandert de situatie. Als deze zijn ingesteld, kunt u het volgende vragen: "Hoeveel hebben we voor elk product en elke maand uitgegeven aan marketing en hoeveel eenheden zijn er verkocht?"
Omdat Verkoop en Marketing beide zijn verbonden met Producten en Datums (gedeelde tabellen), kan het systeem beide meeteenheden nu correct afstemmen -- op product, op maand -- en zinvolle, geaggregeerde resultaten retourneren:
| Product | Maand | Marketinguitgaven | Verkoophoeveelheid |
|---|---|---|---|
| Bike | Jan 2024 | 5000 | 12 |
| Bike | Feb 2024 | null | 8 |
| Auto | Jan 2024 | 10,320 | 22 |
| Auto | Feb 2024 | 5000 | 10 |
Filterwerking
Filters worden toegepast op een manier die voorkomt dat gegevens uit niet-gerelateerde tabellen worden gewijzigd.
- Wanneer u een filter toepast op een feitspecifiek veld, zoals Marketingtype, wordt alleen die feittabel gefilterd, niet elk ander feit of elke andere gedeelde dimensie.
- Wanneer u een filter toepast op een gedeelde dimensie, zoals Productnaam of Datum, is dit van toepassing op alle feittabellen die eraan zijn gekoppeld.
Deze werking voorkomt dat filters niet-gerelateerde records verwijderen. Als u bijvoorbeeld Online selecteert in het filter Marketingtype, worden alleen Marketinguitgaven bijgewerkt -- Verkoophoeveelheid blijft onaangetast.
Feitenbomen moeten cyclusvrij blijven. Cycli introduceren ambiguïteit: als het systeem dezelfde tabel kan bereiken via meer dan één traject, weet het mogelijk niet welke het moet volgen of hoe het filters en aggregaties correct moet toepassen. Om deze reden is het maken van een nieuwe relatie die een cyclus introduceert -- zoals het rechtstreeks verbinden van Marketing met Subcategorie (die al bereikbaar is via Product) -- niet toegestaan.
Berekende velden en Inperking van feitenstructuur
Berekende velden moeten grenzen van de feitenstructuur respecteren. Als u bijvoorbeeld een berekend veld op rijniveau maakt:
ALS [Ondersteuning].[Prioriteit] <= 1 DAN "Hoog" ANDERS "Laag"
-- dat veld is geldig zolang het binnen dezelfde feitstructuur blijft (Ondersteuning in dit geval). U kunt deze gebruiken om patronen te analyseren of ondersteuningsgerelateerde activiteit te filteren op dimensies zoals Klant of Product (als die dimensies worden gedeeld), en alles werkt zoals verwacht.
Als u echter probeert om een berekend veld te maken dat meerdere feittabellen bestrijkt, zoals:
[Inventory].[Quantity] + [Sales].[Sales Quantity]
-- het platform zal een fout veroorzaken. Er wordt geprobeerd om gegevens op rijniveau uit twee verschillende feitstructuren te combineren en het systeem kan geen gemeenschappelijk detailniveau voor die expressie oplossen. Elke feitstructuur heeft zijn eigen onafhankelijke fijnkorreligheid en filtercontext.
Voor geldige kruisfeitberekeningen moet u elk feit afzonderlijk aggregeren en deze aggregaties vervolgens combineren op het niveau van de weergave:
SUM([Inventory].[Quantity]) + SUM([Sales].[Sales Quantity])
Deze expressie is toegestaan omdat beide meeteenheden worden geaggregeerd voordat ze worden gecombineerd, en omdat de aggregatie wordt beperkt tot het productniveau of de dimensie in de weergave.
Beperkingen van gedeelde dimensies en feitenstructuren
- Feittabellen moeten losgekoppeld blijven van elkaar. Ze kunnen niet rechtstreeks worden samengevoegd. Elke verbinding tussen deze tabellen mag alleen plaatsvinden via gedeelde dimensietabellen.
- Berekende velden op rijniveau -- dimensies of meeteenheden -- moeten volledig zijn opgenomen in één feitstructuur.
- U kunt een gedeelde tabel niet verbinden met een andere gedeelde tabel en vervolgens niet met een feittabel. Met andere woorden, er kan slechts één gedeelde tabel bestaan in het verbindingspad tussen een feittabel en de dimensies ervan. Als Producten bijvoorbeeld een gedeelde tabel is die is verbonden met Datums (een andere gedeelde tabel) en vervolgens beide zijn verbonden met Verkoop, wordt deze structuur niet ondersteund.
- Wanneer u velden uit meerdere feitstructuren in dezelfde query filtert, moeten die filters worden gecombineerd met behulp van een voorwaarde AND, niet OR.
- Een nieuwe gedeelde tabel maken
Gebruik gedeelde tabellen om meerdere feittabellen te koppelen via een gemeenschappelijke dimensie om records te vergelijken in verschillende tabellen. Dit houdt uw gegevensmodel schoon en ondubbelzinnig en zorgt ervoor dat filters correct werken binnen verschillende gegevenssets.
