Você está aqui:
Dimensões compartilhadas na semântica do Tableau
Analise e compare dados entre várias tabelas de fatos conectando-as por meio das mesmas tabelas de dimensão. Crie uma análise complexa e relevante para os negócios de maneira limpa e confiável, evitando relacionamentos duplicados e eliminando ciclos em seu modelo semântico.
Na maioria dos conjuntos de dados, diferentes domínios de negócios rastreiam seus próprios eventos separadamente: Vendas rastreiam transações, marketing rastreia campanhas, inventário rastreia níveis de estoque e assim por diante. Cada um desses processos de negócios é representado como uma tabela de fatos, que contém as métricas principais e dados transacionais relevantes para esse domínio.
Para tornar esses dados significativos, cada tabela de fatos se conecta a uma ou mais tabelas de dimensão, como Produtos, Datas, Campanhas, Clientes ou Fornecedores. As dimensões descrevem os fatos e permitem que os usuários os agrupem, filtrem ou agregem (por exemplo, por data, por categoria de produto, por segmento de cliente).
Geralmente, diferentes tabelas de fatos compartilham as mesmas dimensões. Por exemplo, marketing e vendas estão relacionados a produtos e datas.
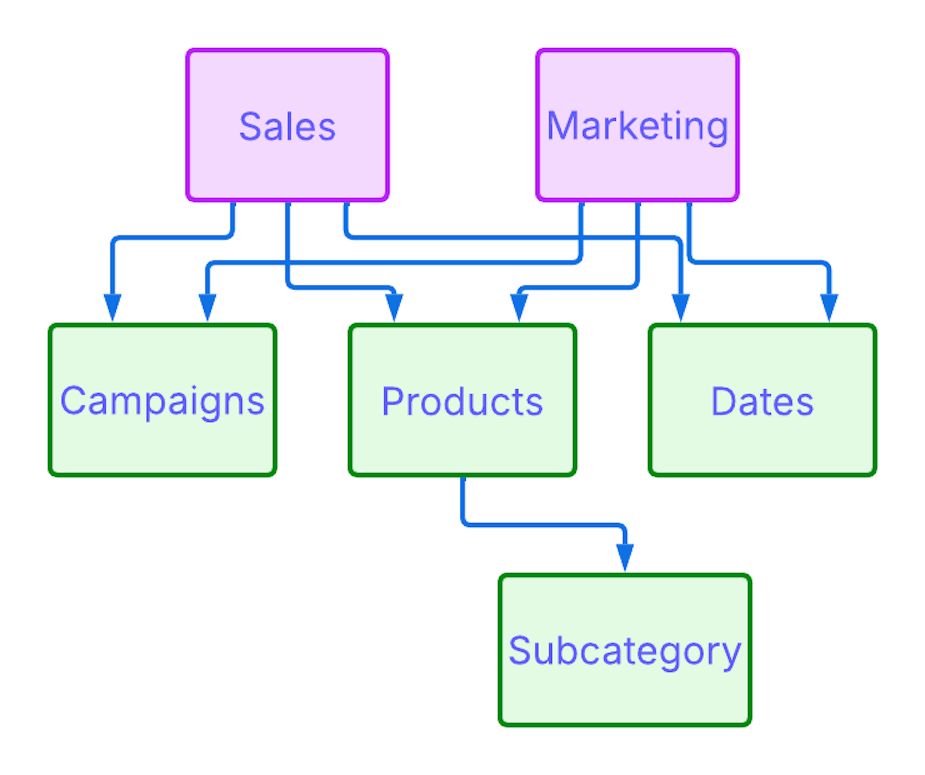
Quando as tabelas de fatos estão relacionadas a uma dimensão compartilhada, sua organização pode alinhar os dados e analisar os valores juntos, permitindo que você:
- Comparar os custos da campanha de Marketing e receita de Vendas por produto
- Divida os níveis de inventário e o desempenho de vendas por fornecedor ou cliente
- Analise a atividade de suporte ao cliente junto com o comportamento de compra e devolução.
Essas consultas abrangem diferentes tabelas de fatos, enquanto as dimensões compartilhadas fornecem os pontos de conexão que permitem reunir esses fatos e explorá-los lado a lado.
Para apoiar isso no modelo semântico, apresentamos o conceito de tabelas compartilhadas. Quando uma tabela de dimensão é marcada como compartilhada, o sistema sabe que ela pode ser usada para conectar várias tabelas de fatos com segurança. Isso habilita uma análise de vários fatos limpa e sem ciclo e garante que o modelo semântico possa interpretar e executar consultas entre domínios corretamente.
Tabelas relacionadas vs. não relacionadas
Um conceito-chave adicional em tabelas compartilhadas é a diferença entre tabelas relacionadas e não relacionadas.
Duas tabelas são consideradas relacionadas quando são conectadas diretamente por um relacionamento definido. As consultas entre tabelas relacionadas funcionam conforme esperado: o sistema usa o caminho definido para uni-los.
Se duas tabelas estiverem completamente não relacionadas, ou seja, não tiverem conexão direta ou compartilhada, o sistema não poderá determinar como combinar os dados e a consulta falhará.
Em alguns casos, as tabelas são conectadas apenas por meio de uma dimensão compartilhada. Se você consultar campos de ambas as tabelas de fatos sem incluir um campo da tabela compartilhada e os campos não forem agregados, o sistema realizará uma junção cruzada. Isso significa que cada linha de uma tabela de fatos é combinada a cada linha da outra, pois não há uma chave compartilhada para alinhá-las.
Por exemplo, se Vendas e Marketing estiverem vinculadas a uma tabela de Produtos compartilhada e você consultar [Vendas].[Quantidade de vendas] e [Marketing].[Gaste] sem [Produtos].[Nome do produto], o sistema simplesmente combinará todas as linhas de Vendas com todas as linhas de Marketing.
Para evitar isso, a consulta deve incluir um campo da tabela compartilhada, como Produto ou Data, que atua como a chave de junção e fornece um eixo compartilhado para agrupar e agregar valores entre os dois fatos.
As dimensões compartilhadas tornam possível analisar dados de tabelas que de outra forma seriam isoladas, mas somente quando usadas corretamente na consulta.
Árvores de fatos e sua estrutura
Uma árvore de fatos é um grupo de tabelas que pertencem à mesma área de negócios e estão conectadas entre si. Geralmente inclui uma ou mais tabelas de fatos junto com tabelas de dimensão.
Essa estrutura não é apenas um conceito de modelagem, é algo que o sistema cria automaticamente quando você executa uma consulta. Árvores de fatos são como a camada semântica organiza internamente as tabelas para avaliar corretamente as dimensões compartilhadas.
No diagrama de exemplo acima, o Marketing é uma tabela de fatos conectada às tabelas compartilhadas Produtos e datas. Isso forma sua árvore de fatos. As vendas são outra tabela de fatos que se conecta às mesmas dimensões compartilhadas, formando uma árvore de fatos separada. Essa estrutura permite que o sistema entenda como cada árvore funciona de forma independente, ao mesmo tempo que habilita a análise entre árvores por meio de dimensões compartilhadas.
As árvores de fatos devem permanecer sem ciclo. Os ciclos apresentam ambiguidade: se o sistema puder chegar à mesma tabela por mais de um caminho, talvez não saiba qual seguir ou como aplicar filtros e agregações corretamente. Por isso, não é permitido criar um novo relacionamento que introduz um ciclo, como conectar o Marketing diretamente à Subcategoria (que já é acessível por meio do Produto).
Como as dimensões compartilhadas afetam as consultas
As dimensões compartilhadas não apenas ajudam a estruturar seu modelo semântico, como também controlam o comportamento das consultas no tempo de execução, garantindo resultados precisos e lógica consistente.
Digamos que você esteja analisando como o gasto de marketing está relacionado à quantidade de vendas. Estas duas medidas vêm de diferentes tabelas de fatos: Marketing e vendas. Por si só, eles não podem ser alinhados de modo significativo porque não há contexto compartilhado pelo qual agrupá-los. Se você simplesmente arrastar ambos os campos para uma consulta sem usar uma referência compartilhada, o sistema não poderá corresponder as linhas e poderá retornar resultados enganosos ou até falhar.
No entanto, quando você traz duas dimensões compartilhadas, como Produto e Data, a situação muda. Com estes em vigor, você pode perguntar: "Para cada produto e mês, quanto gastamos em marketing e quantas unidades foram vendidas?"
Como Vendas e Marketing estão conectadas a Produtos e Datas (tabelas compartilhadas), o sistema agora pode alinhar ambas as medidas corretamente (por produto, por mês) e retornar resultados agregados significativos:
| Produto | Mês | Gasto de marketing | Quantidade de vendas |
|---|---|---|---|
| Bicicleta | Jan 2024 | 5.000 | 12 |
| Bicicleta | fevereiro de 2024 | null | 8 |
| Carro | Jan 2024 | 10,320 | 22 |
| Carro | fevereiro de 2024 | 5.000 | 10 |
Comportamento de filtragem
Os filtros são aplicados de modo a evitar a alteração de dados de tabelas não relacionadas.
- Quando você aplica um filtro a um campo específico de fato, como Tipo de marketing, ele filtra apenas essa tabela de fatos, não qualquer outro fato ou dimensão compartilhada.
- Quando você aplica um filtro a uma dimensão compartilhada, como Nome do produto ou Data, ele se aplica a todas as tabelas de fatos conectadas a ela.
Esse comportamento impede que os filtros removam registros não relacionados. Por exemplo, se você selecionar Online no filtro Tipo de marketing, apenas Gasto de marketing será atualizado -- Quantidade de vendas permanecerá inalterada.
As árvores de fatos devem permanecer sem ciclo. Os ciclos apresentam ambiguidade: se o sistema puder chegar à mesma tabela por mais de um caminho, talvez não saiba qual seguir ou como aplicar filtros e agregações corretamente. Por isso, não é permitido criar um novo relacionamento que introduz um ciclo, como conectar o Marketing diretamente à Subcategoria (que já é acessível por meio do Produto).
Campos calculados e contenção de árvore de fatos
Os campos calculados devem respeitar os limites de árvore de fatos. Se você criar um campo calculado no nível da linha, por exemplo:
SE [Suporte].[Prioridade] <= 1 ENTÃO "Alto" ELSE "Baixo"
-- esse campo é válido desde que fique na mesma árvore de fatos (com suporte neste caso). Você pode usá-lo para analisar padrões ou filtrar a atividade relacionada ao suporte em relação a dimensões como Cliente ou Produto (se essas dimensões forem compartilhadas) e tudo se comportará conforme o esperado.
No entanto, se você tentar criar um campo calculado que abranja várias tabelas de fatos, como:
[Inventário].[Quantidade] + [Vendas].[Quantidade de vendas]
-- a plataforma gerará um erro. Ele tenta combinar dados no nível da linha de duas árvores de fatos diferentes e o sistema não consegue resolver um nível comum de detalhes para essa expressão. Cada árvore de fatos tem sua própria granularidade independente e contexto de filtragem.
Para obter cálculos de fatos cruzados válidos, você deve agregar cada fato de modo independente e, em seguida, combinar esses agregados no nível da visualização:
SUM([Inventário].[Quantidade]) + SUM([Vendas].[Quantidade de vendas])
Essa expressão é permitida porque ambas as medidas são agregadas antes de serem combinadas e a agregação é delimitada para o nível do produto ou qualquer dimensão que esteja na visualização.
Limitações de dimensões compartilhadas e árvores de fatos
- As tabelas de fatos devem permanecer desconectadas umas das outras. Eles não podem ser unidos diretamente. Qualquer conexão entre eles deve ocorrer apenas por meio de tabelas de dimensão compartilhadas.
- Campos calculados no nível da linha, sejam dimensões ou medidas, devem estar totalmente contidos em uma única árvore de fatos.
- Não é possível conectar uma tabela compartilhada a outra tabela compartilhada e, em seguida, a uma tabela de fatos. Em outras palavras, somente uma tabela compartilhada pode existir no caminho de conexão entre qualquer tabela de fatos e suas dimensões. Por exemplo, se Produtos for uma tabela compartilhada conectada a Datas (outra tabela compartilhada) e ambos se conectarem a Vendas, essa estrutura não terá suporte.
- Quando você filtra campos de várias árvores de fatos na mesma consulta, esses filtros devem ser combinados usando uma condição e não OR.
- Criar uma nova tabela compartilhada
Use tabelas compartilhadas para vincular várias tabelas de fatos por meio de uma dimensão comum para comparar registros entre tabelas diferentes. Isso mantém seu modelo de dados limpo e inequívoco e garante que os filtros se comportem corretamente em diferentes conjuntos de dados.
