Du är här:
Delade dimensioner i Tableau Semantics
Analysera och jämför data mellan flera faktatabeller genom att ansluta dem genom samma dimensionstabeller. Bygg komplexa, verksamhetsrelevanta analyser på ett rent och tillförlitligt sätt, undvik dubbletter av relationer och eliminera cykler i din semantiska modell.
I de flesta datauppsättningar följer olika verksamhetsdomäner sina egna händelser separat: Försäljning följer transaktioner, Marknadsföring följer kampanjer, Lager följer lagernivåer och så vidare. Var och en av dessa verksamhetsprocesser representeras som en faktatabell som innehåller de kärnmått och transaktionsdata som är relevanta för den domänen.
För att göra dessa data meningsfulla ansluter varje faktatabell till en eller flera dimensionstabeller, till exempel Produkter, Datum, Kampanjer, Kunder eller Leverantörer. Dimensioner beskriver fakta och låter användare gruppera, filtrera eller aggregera dem (t.ex. efter datum, efter produktkategori, efter kundsegment).
Ofta har olika faktatabeller samma dimensioner. Till exempel är både Marknadsföring och Försäljning relaterade till Produkter och Datum.
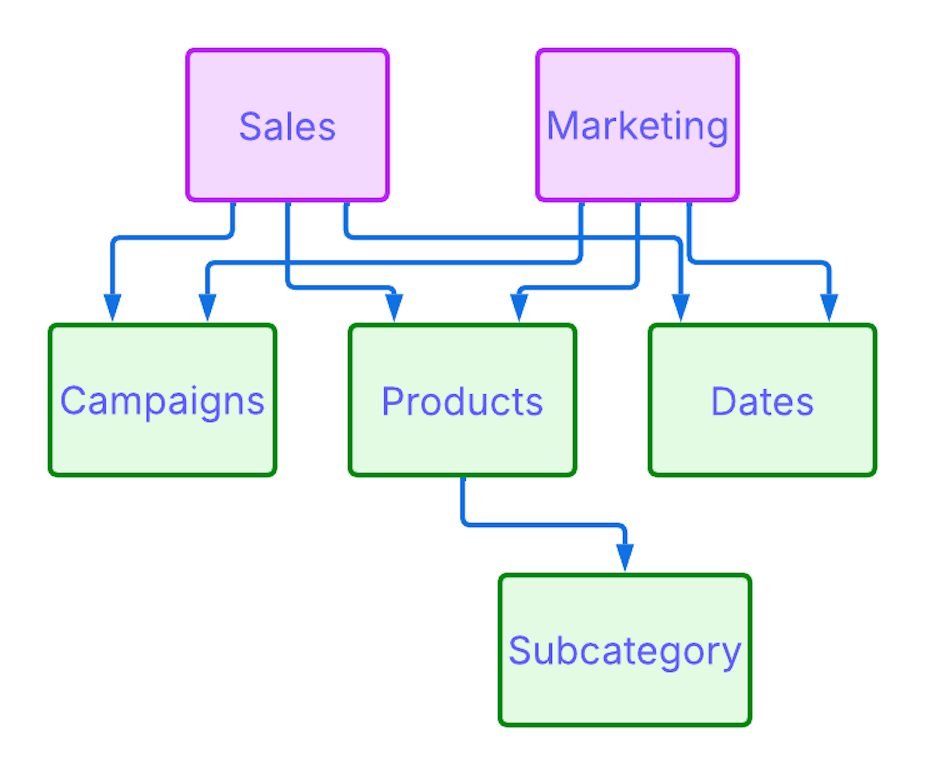
När faktatabeller är relaterade till en delad dimension kan din organisation justera data och analysera värdena tillsammans, vilket gör att du kan:
- Jämför kampanjkostnader från marknadsföring och intäkter från försäljning efter produkt
- Dela upp lagernivåer och försäljningsresultat efter leverantör eller kund
- Analysera kundsupportaktivitet tillsammans med köp- och returbeteende.
Sådana sökfrågor sträcker sig över olika faktatabeller, medan de delade dimensionerna ger de anslutningspunkter som låter dig samla dessa fakta och utforska dem sida vid sida.
För att stödja detta i den semantiska modellen introducerar vi konceptet med delade tabeller. När en dimensionstabell är markerad som delad vet systemet att den kan användas för att ansluta flera faktatabeller säkert. Detta möjliggör ren, cykelfri flerfaktaanalys och säkerställer att den semantiska modellen kan tolka och utföra sökfrågor över domäner korrekt.
Relaterade vs. icke-relaterade tabeller
Ett ytterligare nyckelkoncept i delade tabeller är skillnaden mellan relaterade och icke-relaterade tabeller.
Två tabeller anses vara relaterade när de är direkt sammankopplade av en definierad relation. Sökfrågor mellan relaterade tabeller fungerar som förväntat: systemet använder den definierade sökvägen för att slå samman dem.
Om två tabeller är helt orelaterade – vilket innebär att de inte har någon direkt eller delad anslutning – kan systemet inte avgöra hur deras data ska kombineras och sökfrågan kommer att misslyckas.
I vissa fall är tabeller endast anslutna genom en delad dimension. Om du frågar fält från båda faktatabellerna utan att inkludera ett fält från den delade tabellen och fälten inte är aggregerade utför systemet en korskoppling. Detta innebär att varje rad från en faktatabell kombineras med varje rad från den andra, eftersom det inte finns någon delad nyckel för att justera dem.
Till exempel, om Försäljning och Marknadsföring båda är länkade till en delad produkttabell och du frågar [Försäljning].[Försäljningskvantitet] och [Marknadsföring].[Tillbringa] utan [Produkter].[Produktnamn] kommer systemet helt enkelt att kombinera alla försäljningsrader med alla marknadsföringsrader.
För att undvika detta måste sökfrågan inkludera ett fält från den delade tabellen, som Produkt eller Datum, som fungerar som sammanslagningsnyckel och ger en delad axel för att gruppera och aggregera värden över de två fakta.
Delade dimensioner gör det möjligt att analysera data från tabeller som annars skulle isoleras – men endast när de används korrekt i sökfrågan.
Faktaträd och deras struktur
Ett faktaträd är en grupp av tabeller som hör till samma affärsområde och är anslutna till varandra. Den innehåller vanligtvis en eller flera faktatabeller tillsammans med dimensionstabeller.
Denna struktur är inte bara ett modellkoncept – det är något som systemet bygger automatiskt när du kör en sökfråga. Faktaträd är hur det semantiska lagret internt organiserar tabeller för att utvärdera delade dimensioner korrekt.
I exempeldiagrammet ovan är Marknadsföring en faktatabell som är ansluten till delade tabeller Produkter och Datum. Detta utgör dess faktaträd. Försäljning är en annan faktatabell som ansluter till samma delade dimensioner och bildar ett separat faktaträd. Denna struktur låter systemet förstå hur varje träd fungerar oberoende av varandra, samtidigt som det möjliggör korsträdsanalys genom delade dimensioner.
Faktaträd måste förbli kretsloppsfria. Cyklar introducerar tvetydighet: om systemet kan nå samma tabell genom mer än en väg kanske det inte vet vilket det ska följa eller hur det ska tillämpa filter och aggregeringar korrekt. Av denna anledning är det inte tillåtet att skapa en ny relation som introducerar en cykel -- som att ansluta Marknadsföring direkt till Underkategori (som redan kan nås via Produkt) --.
Hur delade dimensioner påverkar sökfrågor
Delade dimensioner hjälper inte bara till att strukturera din semantiska modell - de styr även hur sökfrågor beter sig vid runtime, vilket säkerställer korrekta resultat och konsekvent logik.
Låt säga att du analyserar hur marknadsföringsutgifter relaterar till försäljningskvantitet. Dessa två mått kommer från olika faktatabeller: Marknadsföring och försäljning. På egen hand kan de inte justeras meningsfullt eftersom det inte finns något delat sammanhang att gruppera dem efter. Om du bara drar båda fälten till en sökfråga utan att använda en delad referens kan systemet inte matcha upp raderna och kan returnera vilseledande resultat eller till och med misslyckas.
När du har hämtat in två delade dimensioner, som Produkt och Datum, ändras situationen. Med dessa på plats kan du fråga: "Hur mycket spenderade vi på marknadsföring för varje produkt och månad och hur många enheter såldes?"
Eftersom försäljning och marknadsföring båda är kopplade till produkter och datum (delade tabeller) kan systemet nu justera båda måtten korrekt – efter produkt, efter månad – och returnera meningsfulla, aggregerade resultat:
| Produkt | Månad | Marknadsföringsutgifter | Försäljningskvantitet |
|---|---|---|---|
| Cykel | Jan 2024 | 5 000 | 12 |
| Cykel | Feb 2024 | null | 8 |
| Bil | Jan 2024 | 10,320 | 22 |
| Bil | Feb 2024 | 5 000 | 10 |
Filtreringsbeteende
Filter tillämpas på ett sätt som undviker att ändra data från orelaterade tabeller.
- När du tillämpar ett filter på ett faktaspecifikt fält, som Marknadsföringstyp, filtrerar det endast faktatabellen – inte andra fakta eller delade dimensioner.
- När du tillämpar ett filter på en delad dimension, som Produktnamn eller Datum, gäller det för alla faktatabeller som är anslutna till den.
Detta beteende förhindrar filter från att ta bort orelaterade poster. Om du till exempel väljer Online i filtret Marknadsföringstyp uppdateras endast marknadsföringsutgifter -- försäljningskvantitet påverkas inte.
Faktaträd måste förbli kretsloppsfria. Cyklar introducerar tvetydighet: om systemet kan nå samma tabell genom mer än en väg kanske det inte vet vilket det ska följa eller hur det ska tillämpa filter och aggregeringar korrekt. Av denna anledning är det inte tillåtet att skapa en ny relation som introducerar en cykel -- som att ansluta Marknadsföring direkt till Underkategori (som redan kan nås via Produkt) --.
Beräknade fält och faktaträdinnehåll
Beräknade fält måste respektera faktaträdgränser. Om du skapar ett beräknat fält på radnivå, till exempel:
IF [Support].[Prioritet] <= 1 DÅ "Hög" ELSE "Låg"
-- detta fält är giltigt så länge det stannar inom samma faktaträd (Stöd i detta fall). Du kan använda den för att analysera mönster eller filtrera supportrelaterad aktivitet mot dimensioner som Kund eller Produkt (om dessa dimensioner delas), och allt kommer att bete sig som förväntat.
Om du försöker skapa ett beräknat fält som sträcker sig över flera faktatabeller, till exempel:
[Lager].[Kvantitet] + [Försäljning].[Försäljningskvantitet]
-- plattformen kommer att skapa ett fel. Det försöker kombinera radnivådata från två olika faktaträd och systemet kan inte lösa en gemensam detaljnivå för det uttrycket. Varje faktaträd har sin egen oberoende detaljnivå och filtreringssammanhang.
För att uppnå giltiga korsfaktaberäkningar måste du aggregera varje fakta oberoende och sedan kombinera dessa aggregeringar på vynivå:
SUM([Lager].[Kvantitet]) + SUM([Försäljning].[Försäljningskvantitet])
Detta uttryck är tillåtet eftersom båda måtten aggregeras innan de kombineras och aggregeringen är begränsad till produktnivå eller vilken dimension som finns i vyn.
Begränsningar för delade dimensioner och faktaträd
- Faktatabeller måste förbli frånkopplade från varandra. De kan inte kopplas direkt. En anslutning mellan dem får endast ske genom delade dimensionstabeller.
- Beräknade fält på radnivå – oavsett om de är dimensioner eller mått – måste finnas i ett enskilt faktaträd.
- Det går inte att ansluta en delad tabell till en annan delad tabell och sedan till en faktatabell. Med andra ord kan endast en delad tabell finnas i anslutningsvägen mellan en faktatabell och dess dimensioner. Till exempel, om Produkter är en delad tabell som är ansluten till Datum (en annan delad tabell) och sedan båda ansluter till Försäljning stöds inte denna struktur.
- När du filtrerar fält från flera faktaträd i samma sökfråga måste dessa filter kombineras med villkoret OCH, inte ELLER.
- Skapa en ny delad tabell
Använd delade tabeller för att länka flera faktatabeller genom en gemensam dimension, för att jämföra poster mellan olika tabeller. Detta håller din datamodell ren och entydig och säkerställer att filter beter sig korrekt i olika datauppsättningar.
