Du är här:
Skapa en modell från grunden
Skapa en modell som använder historiska data för att förutsäga framtida resultat. Välj och strukturera din datakälla och definiera önskat resultat. Träna sedan modellen för att avslöja prediktiva slutsatser och insikter med hjälp av AI, maskininlärning och statistisk analys.
Versioner som krävs
| Tillgängliga i: Alla versioner stöds av Data 360. Se Tillgänglighet för Data 360-version. |
| Användarbehörigheter som krävs | |
|---|---|
| Låt användare hantera modeller i AI-modeller | Gör att du kan skapa, uppdatera och ta bort modeller i AI-modeller. |
| Behörighetsuppsättningar | |
|---|---|
| Data Cloud-arkitekt | Administratörsåtkomst till alla funktioner i AI-modeller, inklusive möjligheten att skapa, uppdatera, ta bort och aktivera modeller. |
| Data Cloud-användare | Begränsad åtkomst för att använda en modell, inklusive att få förutsägelser och förbättringar deriverade från en modell. |
För att lära upp en modell är detta några datakrav att tänka på.
| Krav | Minsta | Maximala |
|---|---|---|
| Antal rader | 400 | 20 miljoner 5 miljoner för XGBoost-algoritmen |
| Antal variabler (fält eller kolumner) | 3 (1 resultatvariabel plus 2 andra fält) | 50 med manuellt val 350 med automatiskt val. Från dessa fält överväger Autopilot endast de 50 mest relevanta. |
Att använda prediktiva modeller för att generera slutsatser konsumerar Data 360-krediter för fakturering. Få reda på mer om hur prediktiv AI påverkar kreditkonsumtion i Faktureringsöverväganden för prediktiv AI.
-
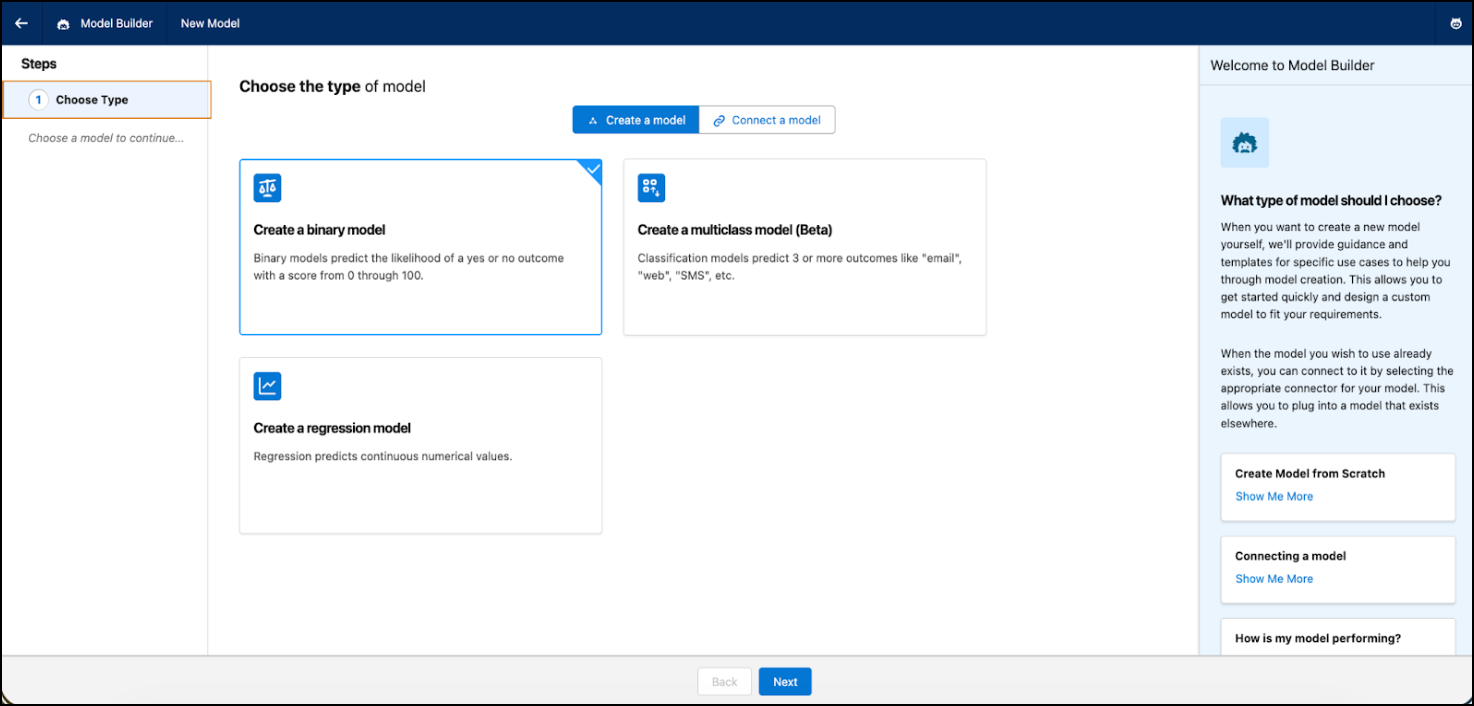
Välj typ
Baserat på ditt användningsfall, välj en binär, regressions- eller flerklassig modell.
-
Välj data
Välj datakällan att lära upp din modell med. Einstein använder dessa data för att lära upp och testa modellen.När du väljer en datakälla, tänk på några vägledande frågor.
Frågor Vägledning Vilket resultat (till exempel nyckeltal) vill du förutsäga? Prediktiv modellering upptäcker mönster relaterade till tre typer av användningsfall: regression (kontinuerliga nummer), binär klassificering (textresultat med två värden) eller flerklassificering (från 3 till 10 möjliga resultat). Idealiska datakandidater för prediktiva modeller involverar ofta nyckeltal associerade med stora datavolymer och många verksamhetsbeslut. Vilka variabler vill du inkludera? Att bestämma vilka variabler som ska inkluderas påverkar kvaliteten och tolkningen av en prediktiv modell. När variabler är meningsfulla och relevanta blir det enklare för intressenter och affärsanvändare att förstå relationerna mellan faktorer och Trust de förutsagda resultaten. Var kan du hitta denna information? Att förstå var data kommer ifrån är värdefullt för att bedöma kvalitet, identifiera biasering och följa datastyrning och efterlevnad. -
Välj utbildningsdata
Använd alla poster i datakällan för att lära upp modellen. Eller specificera villkor för att begränsa de poster som används för att lära upp modellen.
- För att välja en specifik underuppsättning data för att lära upp modellen, klicka på Filtrerad uppsättning poster.
-
Definiera ditt filtervillkor.
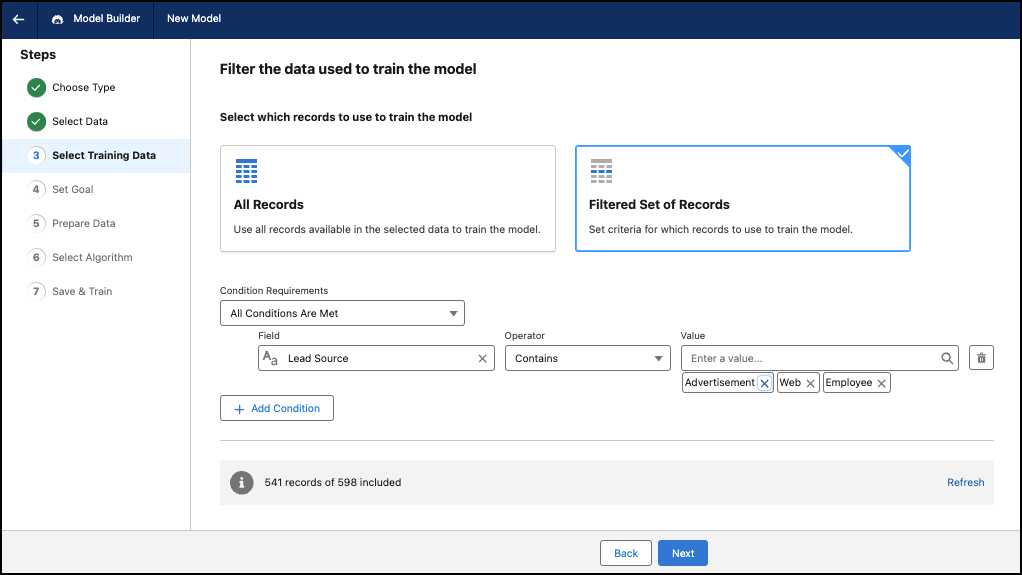
Logik Beskrivning Villkorskrav Alla villkor uppfylls—om alla villkor är sanna tillämpas filtret. Om ett av villkoren är falskt tillämpas inte filtret.
Något villkor uppfylls—om ett villkor är sant tillämpas filtret.
Fält Baserat på datakällan. Det dataattribut eller variabel som ska användas vid tillämpning av filtret. Operator Definierar relationen mellan fältet och villkoret. Tillgängliga operatorer beror på fälttypen. Värde Specifikt värde för att bedöma fältet. För textfält, välj ett eller flera värden. För numeriska fält, ange ett värde. För datumfält, använd kalendern för att välja ett datum.
-
Sätt mål
Välj ett verksamhetsproblem som du vill lösa. Kontrollera vilka nyckeltal (KPIs) som du vill förbättra. Utforska vilka kandidatnyckeltal som kan dra mest nytta av att distribuera en AI-driven lösning.
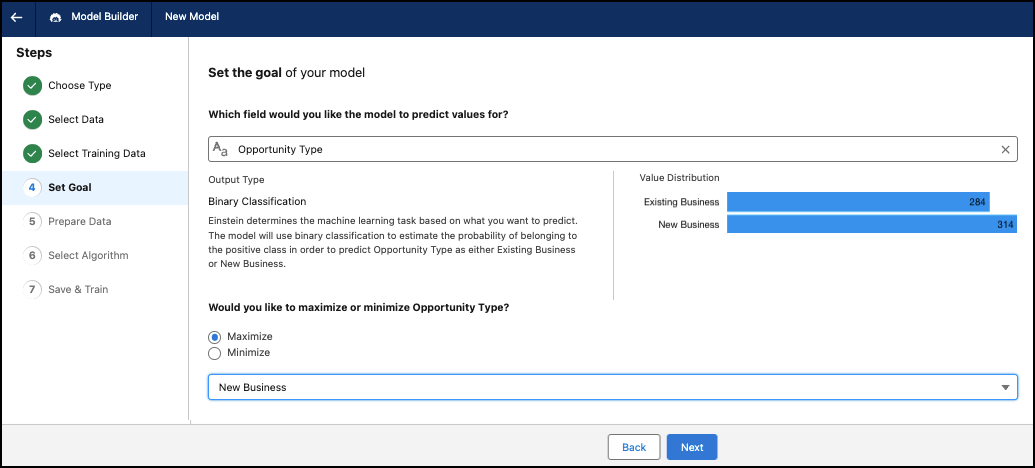
- Välj det fält som du vill förutsäga värden för. Bestäm dig för vilken resultatvariabel som du vill undersöka och med vilken detaljrikedom. Resultatvariabeln kan vara ett nyckeltal (till exempel intäkt, rabatt, kostnadsmått eller varaktighet) eller ett annat kvantifierbart resultat. Du kan även använda kategorier (textfält) med två värden (binära) som resultatvariabel.
- Välj att maximera eller minimera ditt mål. Einstein bygger och utbildar en modell som fokuserar på att maximera eller minimera resultatvariabeln. Ditt mål kan till exempel vara att öka nettomarginalen eller minska kundbortfallet. Einstein bygger en modell som fokuserar på att uppnå högre nettomarginal eller minska kundbortfall.
-
Förbered data
Välj vilka fält som ska inkluderas som variabler i modellen. Se till att variablerna är relevanta för det verksamhetsresultat du vill förutsäga. Förfina data för att ge bättre resultat genom att använda variabler som är korrekta, fullständiga och representativa för verkliga affärsverksamheter vad gäller kvantitet (volym) och variation (diversitet). Använd inte fält som innehåller känsliga data eller personligt identifierande information (PII).
-
Välj algoritm
Algoritmen är det tillvägagångssätt, eller den beräkningsprocess, som modellen använder för att lära sig från data och göra förutsägelser. Du kan även slå på Automatiskt urval så att Einstein automatiskt kan välja en algoritm som har störst påverkan på din förutsägelse och ditt användningsfall.
-
Välj algoritmen för din modell.
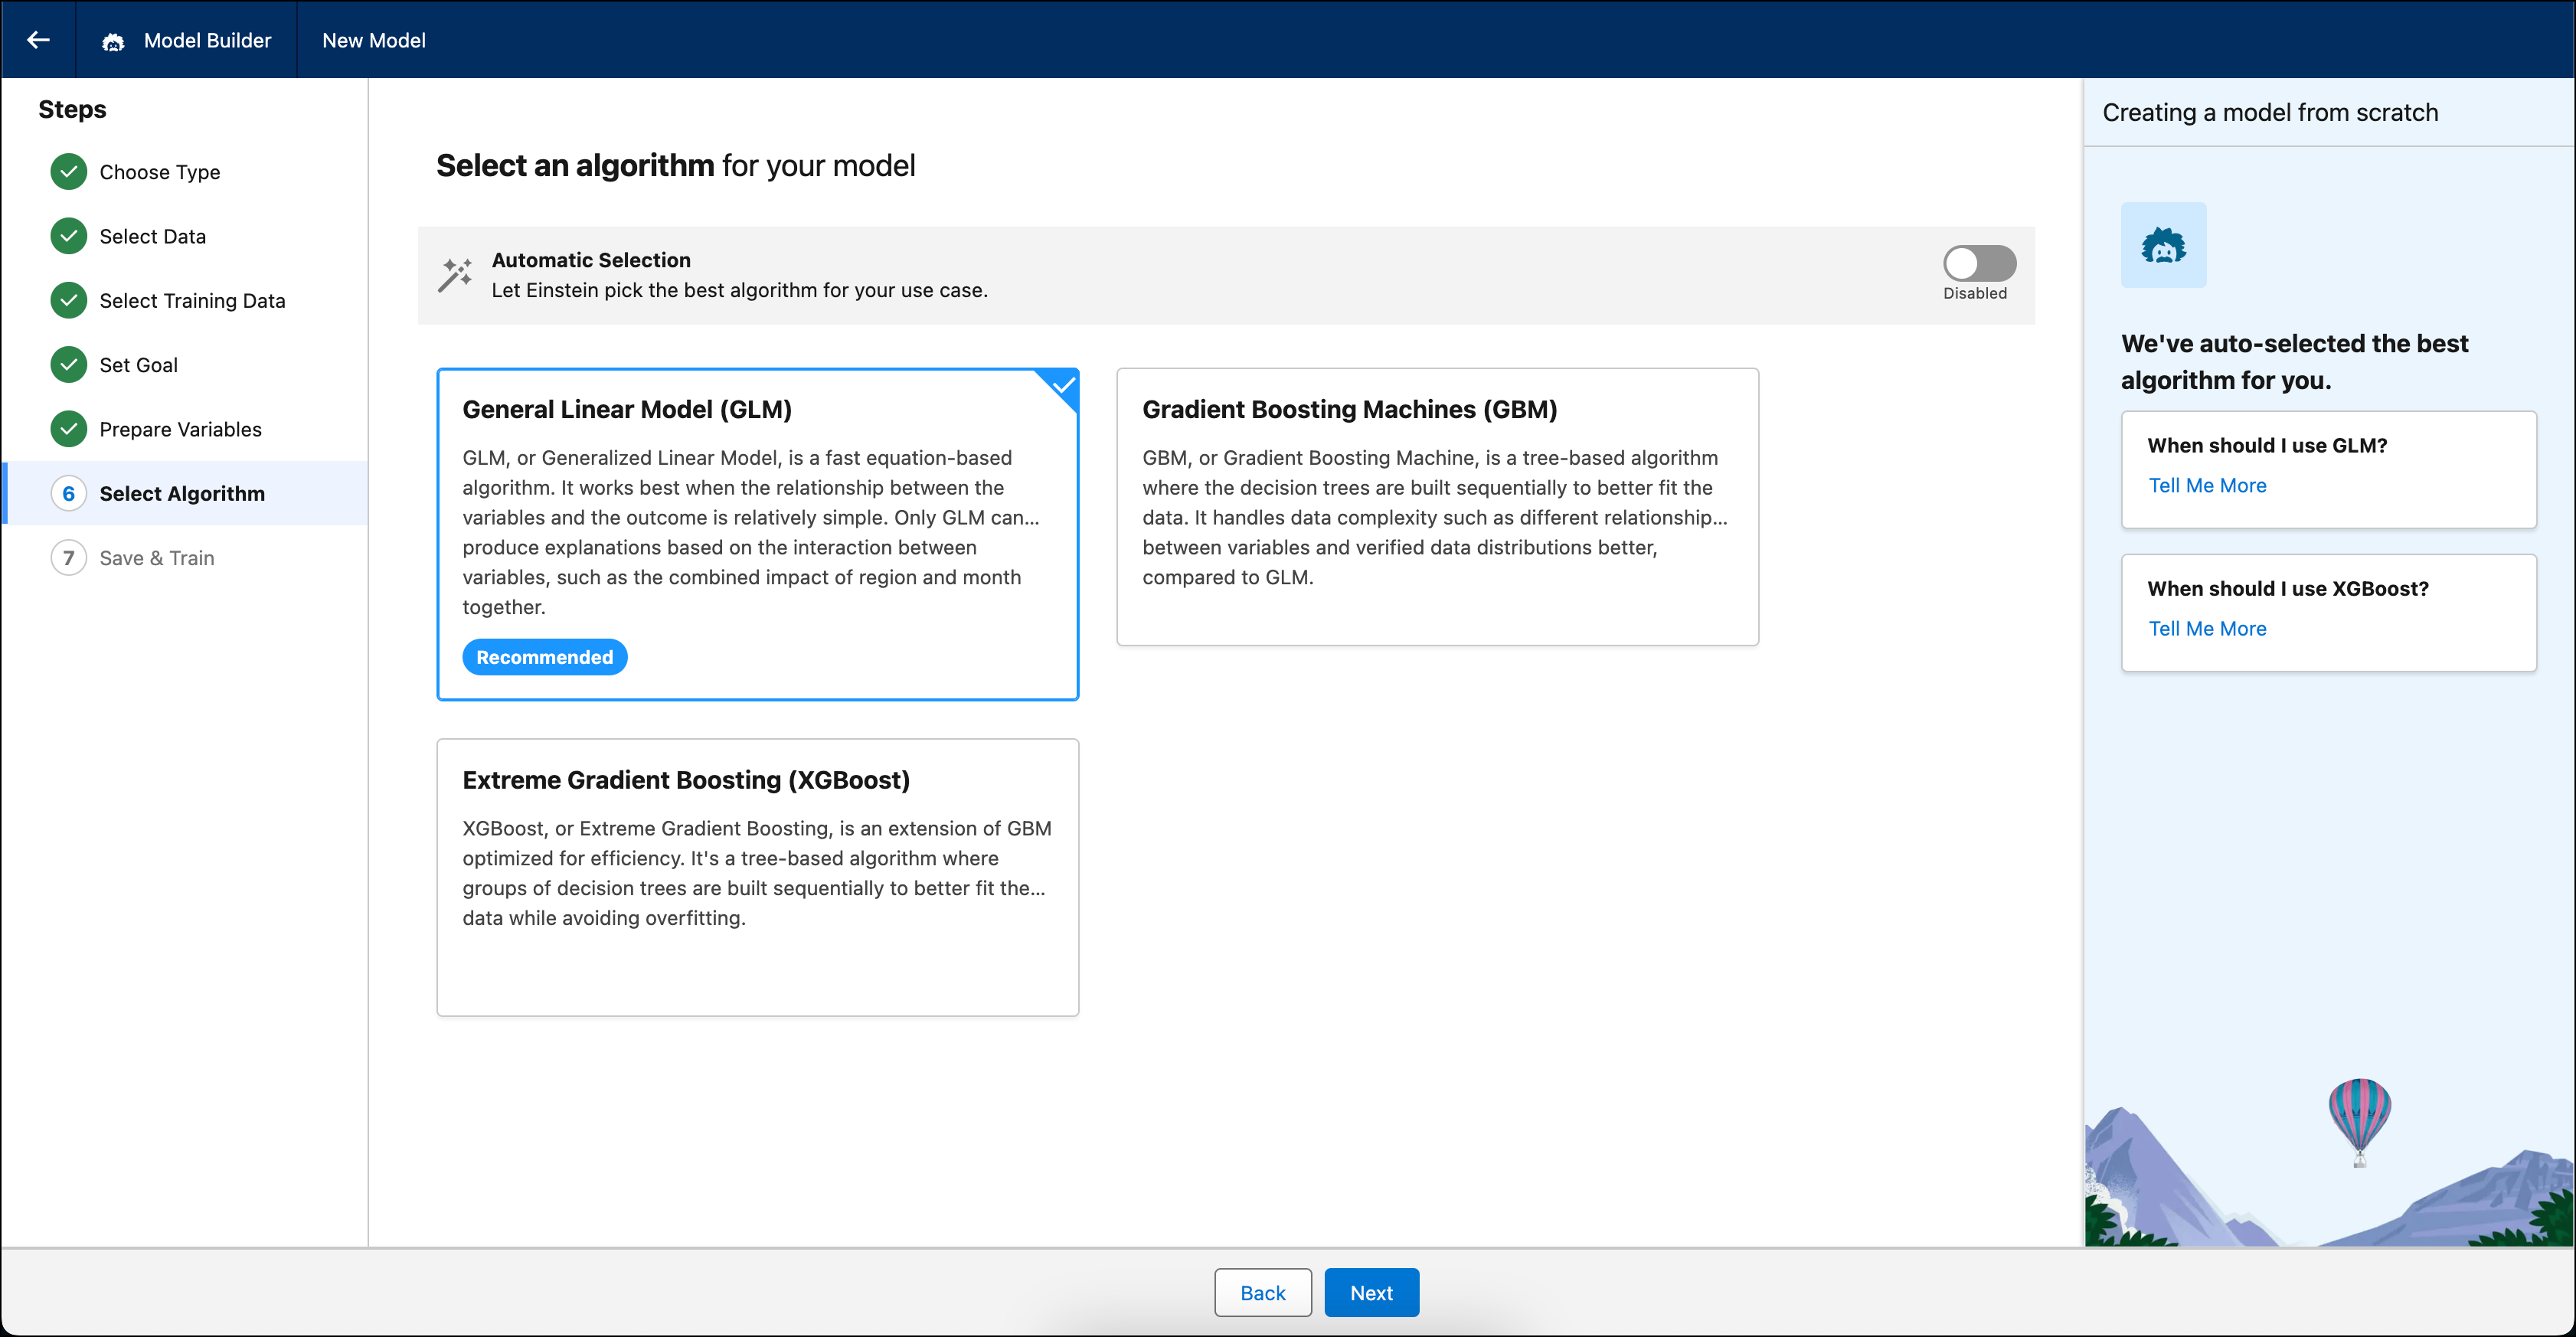
Algoritm Beskrivning GLM Standard. Generaliserad linjär modell (GLM) är en ekvationsbaserad algoritm som vanligtvis slutförs snabbt. Det fungerar bäst när relationen mellan variablerna och resultatet är relativt enkelt. Endast GLM kan skapa förklaringar baserat på interaktionen mellan variabler, till exempel den kombinerade påverkan av region och månad tillsammans. GBM Gradientboosting Machine (GBM), är en trädbaserad algoritm där beslutsträden byggs sekventiellt för att bättre passa dina data. Den hanterar datakomplexitet som olika relationer mellan variabler och olika datadistributioner bättre jämfört med GLM. XGBoost Extreme Gradient Boosting (XGBoost), är ett tillägg av GBM som är optimerat för effektivitet. Det är en trädbaserad algoritm där grupper av beslutsträd byggs sekventiellt för att bättre passa dina data och samtidigt undvika överanpassning.
-
Välj algoritmen för din modell.
-
Granska och utbilda
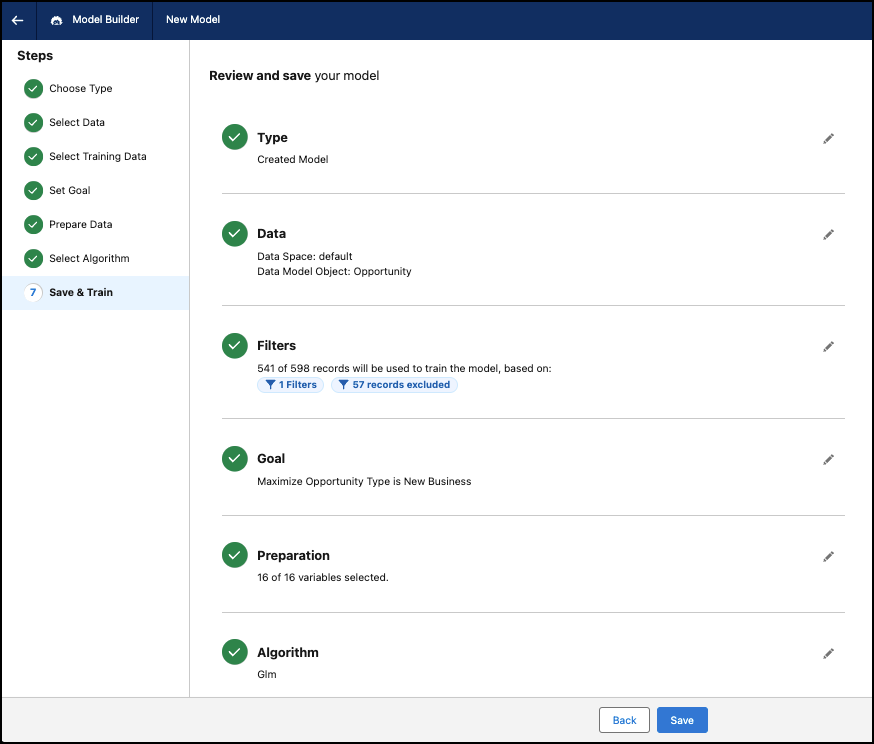
Utbilda din modell efter att du har gått igenom detaljerna.
-
Gå igenom detaljerna för modellen. Om du vill kan du klicka på pennikonen för att redigera ett steg.
 Anteckning
Du kan redigera alla steg när du skapar en modell. När du har skapat modellen går det inte att redigera steg som: Välj Typ, Välj data och Ange mål.
-
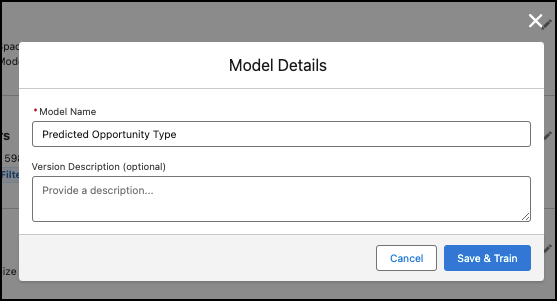
Klicka på Spara för att ange ett namn och en valfri beskrivning för din modell och klicka på Spara och träna för att skapa modellen.
-
Gå igenom detaljerna för modellen. Om du vill kan du klicka på pennikonen för att redigera ett steg.

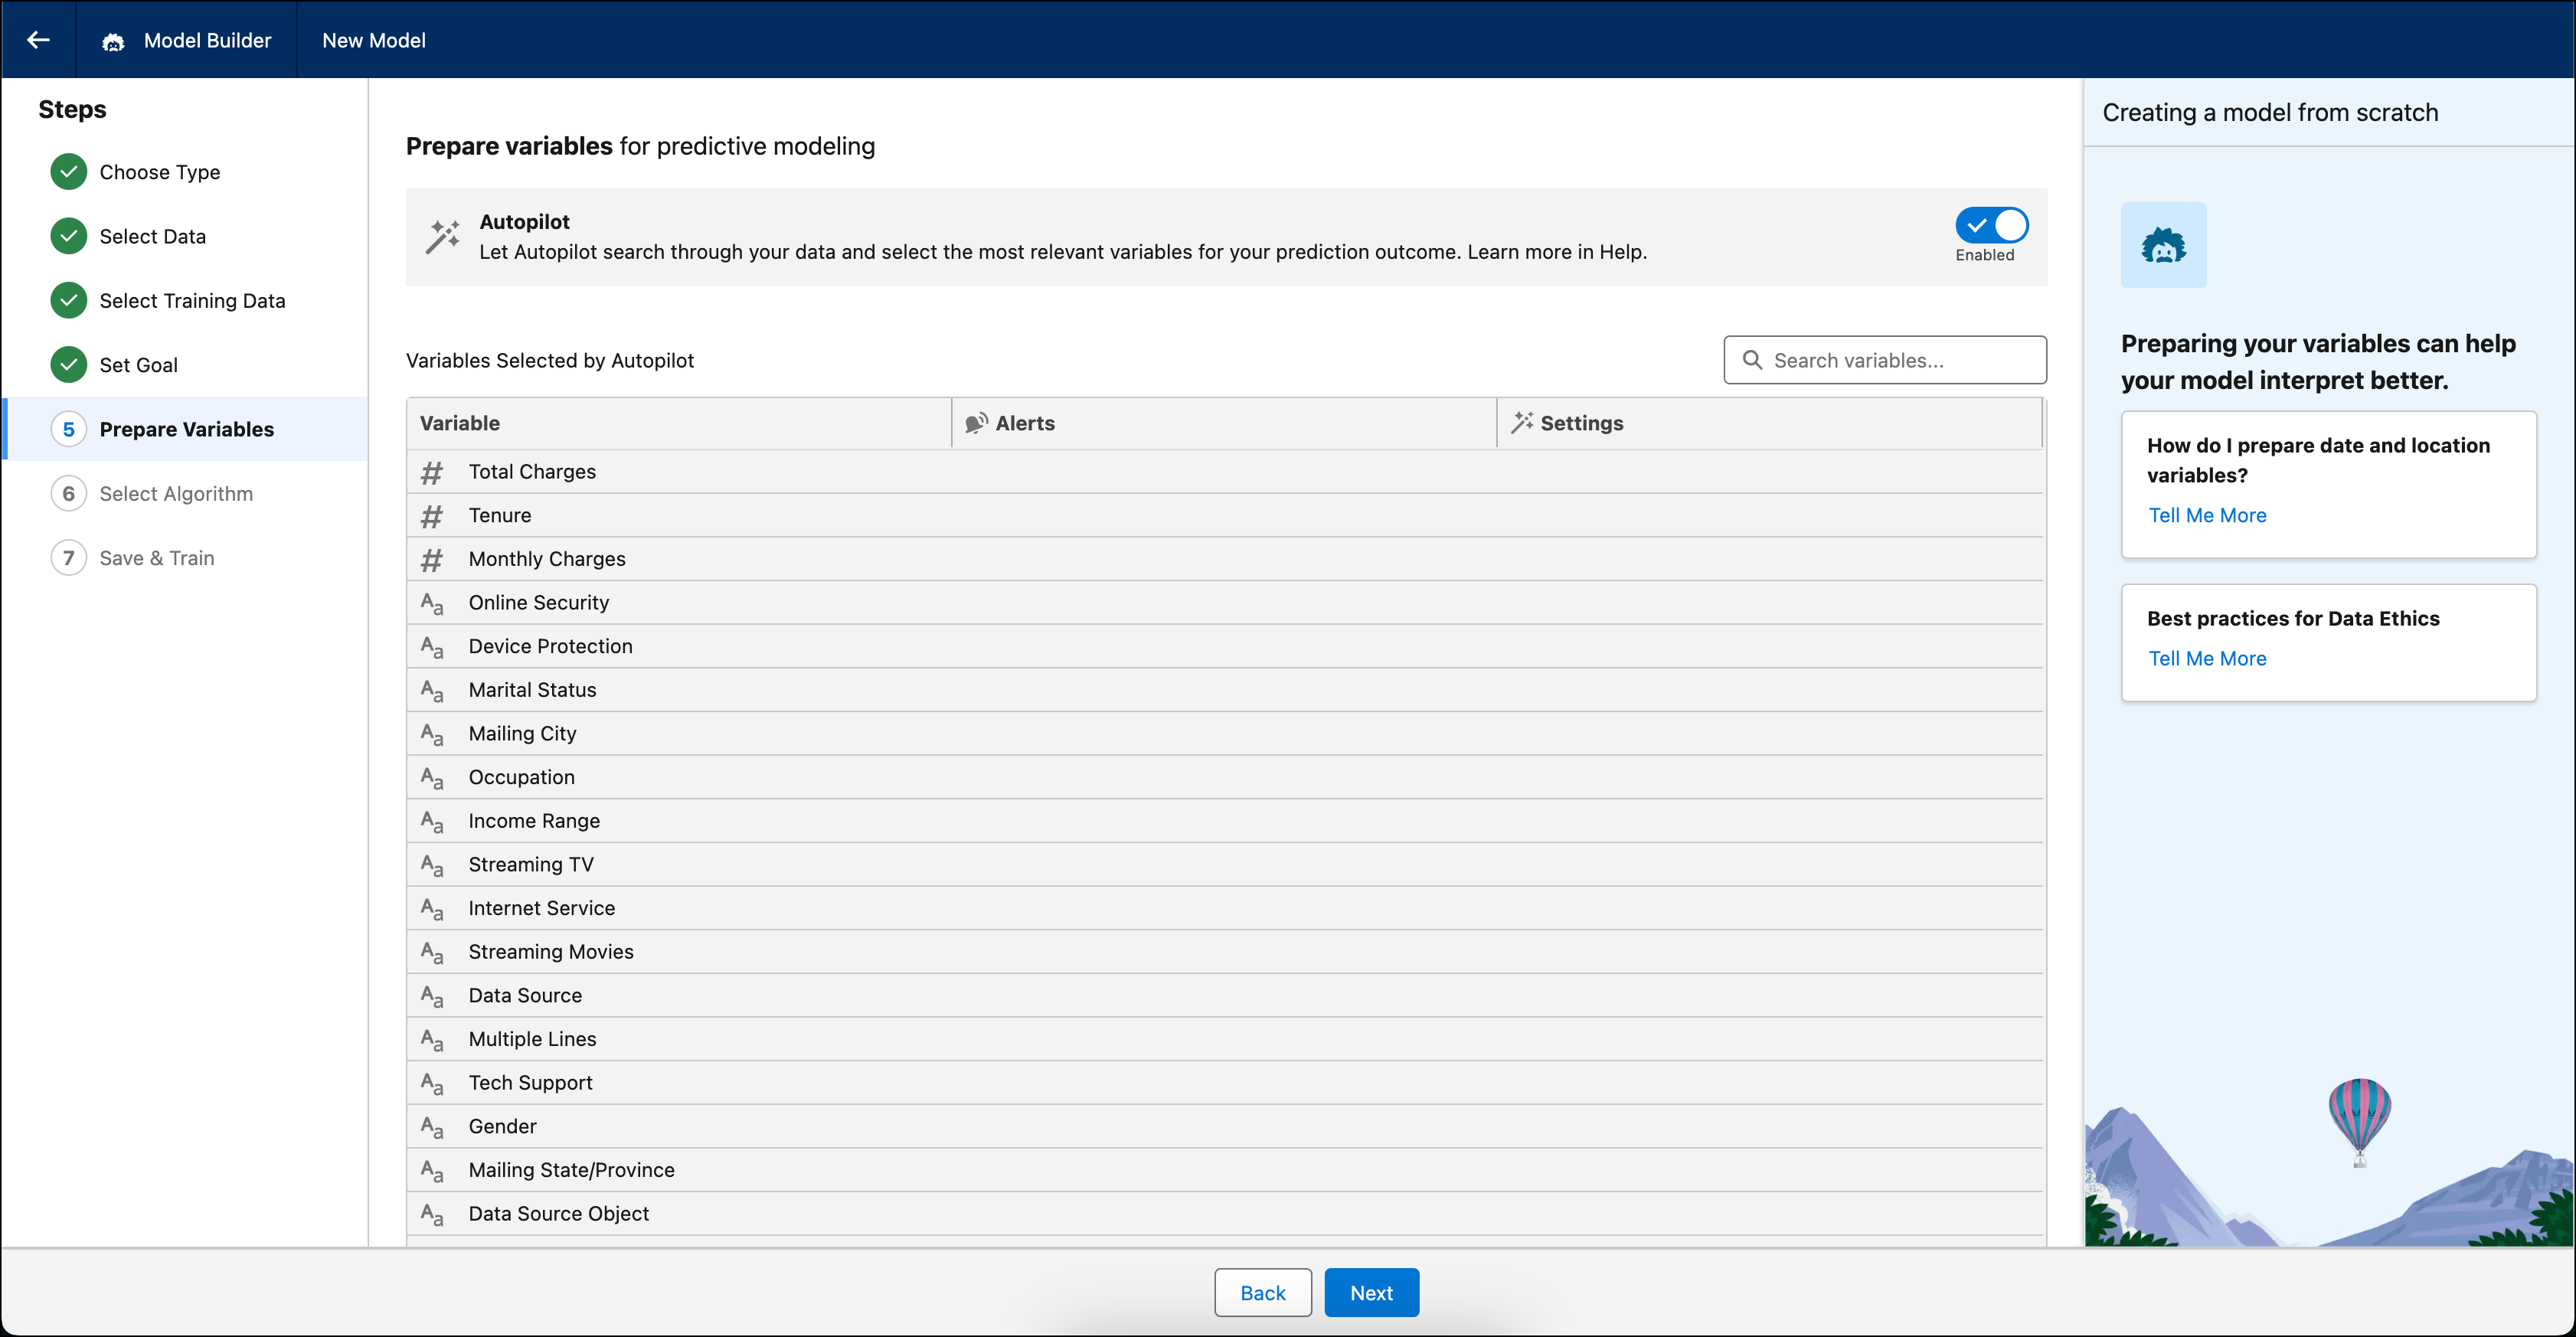
Einstein analyserar data och utbildar modellen baserat på dina inställningar. Det tar tid att skapa en modell och Einstein visar förloppet längs vägen så att du vet hur många minuter som återstår.
När modellen har skapats kan du hitta den på fliken Prediktiva modeller i AI-modeller. Se Startsidan för AI-modeller.
- Hantera dataproblem
Hantera vanliga problem som du kan stöta på när du förbereder data för modellbygge och efter att du har utbildat en modell. - Tillämpa transformationer på dina data
Transformera modelldata för att förbättra pålitligheten, precisionen och förklarligheten för förutsägelser. För modeller som skapats från grunden transformerar Modellbyggaren automatiskt ostrukturerad text och ersätter data som saknas. Du kan även manuellt transformera variabler i binära modeller eller regressionsmodeller.
