您在此处:
混合搜索融合排名
排名会重新排序搜索结果,以便与用户查询最相关的结果位于顶部。Data 360 混合搜索根据与查询的相似性从两个索引(关键字和向量)检索结果,然后合并(融合)结果。然后,排名模型对合并结果进行重新排名。
在设置期间,您可以配置其他排名因素,例如记录的最近度和受欢迎程度,以影响排名。排名系数基于搜索索引对象字段或相关对象字段。例如,您可以使用索引 DMO 的 LastModifiedDate 字段来定义记录的最近。
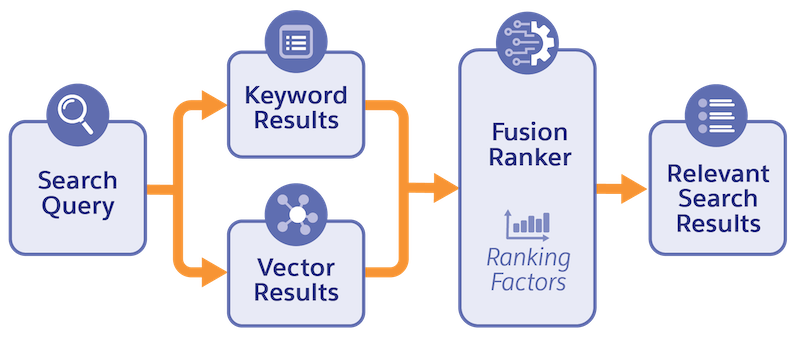
Salesforce 融合排名模型根据各种基于搜索的任务的内部基准进行了优化。基准衡量精度、鲁棒性和灵敏度的性能,以生成高质量的模型。评估标准由用户对搜索响应和注释的交互组合确定。训练和评估数据基于从 Salesforce Einstein 搜索和 RAG 应用程序捕获的查询,例如 Einstein 搜索答案。
影响向量和关键字搜索相似性分数的因素有很多。例如,关键字相似性分数取决于查询文本和搜索索引 DMO 的内容。向量相似性分数取决于查询文本和搜索索引的特定嵌入模型。融合排名器模型返回的混合搜索分数是关键字和向量相似性分数以及排名因素的线性组合。
为了给一般混合搜索用例提供最佳结果,该模型针对最佳组合进行了微调,包括每个分数的归一化策略以及每个分数的权重。融合排名模型根据派生的混合搜索分数确定结果的最终排名。即使其中一个搜索相似性分数为零,该模型也可以对具有高混合搜索分数的结果进行排名。例如,如果关键字得分为零的结果的矢量得分相对于同一搜索查询的替代结果的矢量得分足够高,则混合搜索得分可能很高。
| 搜索类型 | 得分参数 | 描述 |
|---|---|---|
| 矢量搜索 | vector_score__c | 给定查询的基础向量搜索索引索引返回的相似性分数。 |
| 关键字搜索 | keyword_score__c | 给定查询的基础关键字搜索索引返回的相似性分数。 |
| 混合搜索 | hybrid_score__c | 从组合关键字和向量分数得出的分数。此分数会考虑排名因素,例如文档受欢迎程度和最近程度。此分数决定结果的排名。 |

示例 考虑带有特定域词的搜索字符串的混合搜索查询,例如“V2MOM”。排名模型返回向量分数、关键字分数和混合搜索分数,然后对结果集进行排名。
select * from hybrid_search(
      table(<Search_Index_DMO>),
      "When is the V2MOM due?",
      <Pre-Filter Fields>, <Limit Results>);
| 块 ID | 矢量得分 | 关键字得分 | 混合得分 | 最终排名 |
|---|---|---|---|---|
| A | 0.85 | 10.0 | 0.9 | 1 |
| B | 0.90 | 1.0 | 0.8 | 2 |
| C | 0.80 | 0.5 | 0.6 | 3 |
| D | 0.75 | 0.01 | 0.5 | 4 |
示例 在本例中,混合搜索查询包括影响最终排名的热门和最近排名因素。

select * from hybrid_search(
          table(<Search_Index_DMO>),
          "How do I reset the password for my Acme account?",
          <Pre-Filter Fields>, <Limit Results>);
| 块 ID | 矢量得分 | 关键字得分 | 流行度 | 最近(天) | 混合得分 | 最终排名 |
|---|---|---|---|---|---|---|
| A | 0.91 | 10.0 | 1000(高度热门) | 10(最近) | 0.9 | 1 |
| B | 0.90 | 10.5 | 1 | 15 | 0.875 | 2 |
| C | 0.80 | 2 | 5 | 25 | 0.8 | 3 |
| D | 0.80 | 1 | 10 | 100 | 0.75 | 4 |
备注 这些示例显示了如何从关键字和向量相似性分数以及排名因素中得出混合搜索分数。分数值不是绝对的,实际上必须只用于比较同一查询的排名结果。
本文章是否解决您的问题?
请与我们共享您的想法,以便我们进行改进!
