Du är här:
Påverka hybridsökningens relevansrangordning
Öka precisionen i sökindexens sökfrågeresultat och förbättra kvaliteten på RAG-ansökningar genom att skicka relevansspecifika parametrar. Med SQL kan du skicka konfigurationsinställningar för relevans för modeller med fusionsrangordning som stöds och förbättra resultatrelevansen för ditt specifika användningsfall.
Hybridsökning har stöd för tre fusionsrangordningsmodeller: branschstandardmodellen för ömsesidig rangordningsfusion (RRF), en anpassningsbar modell för linjär fusionsrangordning (LFR) och en mer robust DFR-modell (Deep Fusion Ranker).
En hybridsökningsfråga accepterar en JSON-sträng som representerar relevanskonfigurationsinställningen.
select * from hybrid_search(
    table(<Search_index_DMO>),
    ‘<Search_string>’,
    '<PreFilteringColumn><Operator><Value>',
    '<Limit_results>',
    ‘<”Relevance Ranking Configuration” (JSON)>’
);
Ömsesidig rangordningsfusionsmodell
Modellen för ömsesidig rangordningsfusion (RRF) använder en formel för ömsesidig rangordningsfusion som överväger vikten för varje söktyp för att få de mest relevanta resultaten.
Den ömsesidiga rangfusionsformeln är summan av både nyckelordssökning (gles) och vektorsökning (tät) ömsesidiga rangbetyg med ett standardsönderfall på k=60. Formeln ger även en alfaparameter, som styr den glesa vikten i en konvex kombination av de två betygen. Sökresultaten rangordnas med hjälp av summan som deriveras från RRF-rangordningens fusionsformel.
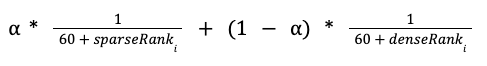
Till exempel skickar detta hybridsökfrågeuttryck nyckelordssökningens (glesa) viktparameter för RRF-modellen.
select * from hybrid_search(
    table(<Search_index_DMO>),
    ‘<Search String>’,
    '<PreFilteringColumn><Operator><Value>',
    '<Limit Results>',
    ‘{ "rrf": { "keyword_weight": 0.4 } }’
);
Indataparametrar för relevanskonfiguration:
- rrf: Aktivera fusionsmodell för ömsesidig rangordning
- keyword_weight: Vikten eller vikten av nyckelordssökningskomponenten i hybridsökning. Intervallet är mellan noll och ett. Vektorsökningens betydelse beräknas automatiskt genom att dra av nyckelordets vikt från 1,0.
RRF-modellen har även stöd för en avancerad formel som kan påverka de rangordningsfaktorer du konfigurerar när du skapar sökindexet. Mer information om rangordningsfaktorer finns i Rangordning för hybridsökning.
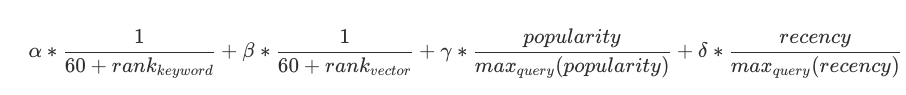
Indataparametrar för relevanskonfiguration i den avancerade RRF-formeln:
- Alfa (a): representerar den vikt som läggs vid nyckelordssökning. Standard är 0,5f
- Beta (B): representerar den betydelse som ges till vektorsökning och beräknas baserat på den betydelse som ges till nyckelordssökning (1-alpha).
- Gamma (Y): representerar vikten av rangordningsfaktorns popularitet. Standard är 0,00074478f. Maximalt är 1.
- Delta (D):representerar vikten av rangordningsfaktorers återkomst. Standard är 0,00028472f. Maximalt är 1.
Specificera vikten av vikter i din sökfråga. Justera och precisera värdena i låga steg för att säkerställa att du uppnår rätt relevans för dina resultat.
Rangordningsmodell för linjär fusion
Modellen för linjär fusionsrangordning (LFR) är en anpassningsbar form av standardmodellen för fusionsrangordning, som beräknar en viktad summa av de transformerade betygen från både vektorsökning (tät) och nyckelordssökning (gles). Sökresultaten rangordnas med hjälp av summan som deriveras från LFR-formeln.
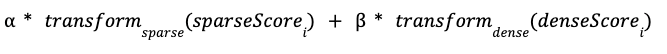
Som standard ger hybridsökning den bästa konfigurationen för linjär fusionsrangordning med hjälp av transformationer och vikter baserat på interna experiment och riktmärken. Med LFR går det att konfigurera rangordningen ytterligare med hjälp av transformationsfunktionerna för nyckelordssökningens (glesa) betyg och vektorsökningens (täta) betyg, och deras vikter.
LFR-modellen kan även använda rangordningsfaktorerna för återkomst och popularitet som kan konfigureras vid konfigurering av hybridsökning för en DMO. De ytterligare rangordningsfaktorerna kan konfigureras med transformationsfunktioner och vikter.
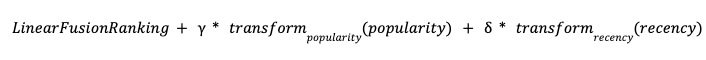
Till exempel skickar detta hybridsökfrågeuttryck relevansparametrar för LFR-modellen.
select * from hybrid_search (
    table(<Search_index_DMO>),
    ‘<Search String>’,
    '<PreFilteringColumn><Operator><Value>',
    '<Limit Results>',
‘{
  "lfr": {
    "vector": {
      "score_transform": {
        "type": "reciprocal_rank",
        "decay": 60
      },
      "weight": 0.66913
    },
    "keyword": {
      "score_transform": {
        "type": "query_min_max",
        "theoretical_min": 0.1
      },
      "weight": 4.0343633
    }
  }
}’);
Indataparametrar för relevanskonfiguration:
- lfr - Aktivera modell för linjär fusionsrangordning
- vektor: Konfigurerar rangordning för vektorsökning
- nyckelord: Konfigurerar rangordning för nyckelordssökning
Var och en av rangordningskonfigurationerna för vektor- och nyckelordssökning kan ta dessa parametrar:
- score_transform: Konfigurationen för betygstransformation för sökkomponenten
- type: Typen av betygstransformation
- reciprocal_rank
- query_min_max
- sönderfall: Avvikelseparametern stöds endast för ömsesidig rangordningstransformation och styr gradienten mellan resultatrangordningarna. Till exempel är det ömsesidiga rangbetyget mellan resultat rangordnade 1 och 2 längre ifrån varandra med ett förfall på 10 jämfört med ett förfall på 20.
- Om sökfrågan innehåller en decay-parameter får du betyg = 1/(rank+decay).
- theory_min: Stöds endast för teoretisk min/max-transformation, motsvarar det teoretiska minimibetyget för den underliggande sökfunktionen. Använd denna parameter för att skala funktionsfördelningen upp eller ner i ett intervall mellan [0,1]. Så välj ett värde som är det lägsta värdet för funktionen för att få det bästa resultatet. För nyckelordets sökbetyg är 0 det lämpliga värdet. Justera inte detta värde om du inte har data som indikerar att ett högre värde ger bättre relevans.
- weight: Vikten att ge till denna komponent i hybridsökning
Deep Fusion-rangordningsmodell
Modellen Deep Fusion Ranker (DFR) förbättrar sökrelevansen genom att integrera traditionella signaler som vektorlikhet, nyckelordsmatchningar, popularitet och återkommande med en djupare förståelse av sökfrågetexten. Genom att använda tekniker för djupinlärning och transformatorarkitekturer samlar modellen in komplexa funktionsinteraktioner och betygsätter poster tillsammans. Sökresultaten är korrekta, preciserade och sammanhangsrelevanta. Modellen hanterar effektivt saknade och brusiga data, vilket säkerställer tillförlitlig prestanda i olika sökscenarier.
Aktivera Deep Fusion Ranker-modellen med konfigurationsinställningen för dfr-relevans. Det finns inga andra anpassningar tillgängliga för denna modell.
Till exempel skickar detta hybridsökfrågeuttryck relevansparametern för Deep Fusion Ranker-modellen.
select * from hybrid_search (
    table(<Search_index_DMO>),
    ‘<Search String>’,
    '<PreFilteringColumn><Operator><Value>',
    '<Limit Results>)',
    ‘{  "dfr": {}}’
);
Indataparametrar för relevanskonfiguration:
- dfr: Aktivera Deep Fusion Ranker-modell
