breadcrumbDescription
Opdelingsstrategier
Data 360 understøtter flere segmenteringsstrategier. Data 360 vælger automatisk den optimale segmenteringsstrategi baseret på den indholdstype, du arbejder med.
Overvej f.eks. de felter, der giver den mest relevante kontekst og semantiske betydning, hvordan du opdeler disse felter, og hvordan du forventer, at de hentede resultater bruges i din Einstein Gen AI, automatisering, analyse applikation. Opdel f.eks. de tilpassede tekstfelter i et Knowledge ved brug af passageudtrækningsstrategien for at gøre det nemmere at returnere semantisk ens resultater, når du søger på tværs af Knowledge.
- Section-Aware segmentering
- Semantisk baseret passageekstraktion
- Samtalebaseret segmentering
- Prepend felt segmentering
- Kodeudvidelse
Afsnitsbevidst segmentering
Afsnitsbevidst segmentering bruger titel- og overskriftselementer til at segmentere dokumenter. Al tekst under en afsnitstitel eller et overskriftselement segmenteres sammen, indtil Data 360 støder på en ny afsnitstitel eller et nyt overskriftselement. Dette giver dig mulighed for at opdele indhold i sammenhængende afsnit baseret på strukturen i et dokument.
Afsnit opdeles aldrig vilkårligt – segmenter respekterer altid naturlige indholdsgrænser og bevarer læsbarhed og kontekst. Nogle gange identificeres korte afsnit eller listeelementer forkert som enkeltstående afsnit Dette kan føre til for små segmenter. For at undgå dette skal du bruge disse indstillinger, når du opretter et søgeindeks.
- Maks. token: Kombiner tilstødende små afsnit i en større segment, så du optimerer for segmentstørrelse uden at ofre sammenhæng. Se Hvordan indstillingen for Maks. token påvirker segmentering.
- Overlapningstokener: Bruges kun, når der oprettes flere segmenter fra et enkelt afsnit. Angiv antallet af tokener, der skal tilføjes fra slutningen af hver segment til starten af den næste segment. Dette skaber kontekstmæssig overlapning mellem på hinanden følgende segmenter, hvilket sikrer problemfri overgange og bedre ydeevne i opgaver som søgning og hentning.
Du kan gruppere flere afsnit i en enkelt segment, hvis det kombinerede indhold forbliver inden for den konfigurerede tokengrænse.
Når tokengrænsen er nået, sikrer segmenteringslogikken rene pauser – den opdeles ikke midt i en sætning eller et afsnit. I stedet udvides den til slutningen af afsnittet og bevarer den semantiske og strukturelle integritet på tværs af segmenter.
Denne tekst er f.eks. opdelt i afsnit baseret på dens titel og følgende afsnitsoverskrifter.
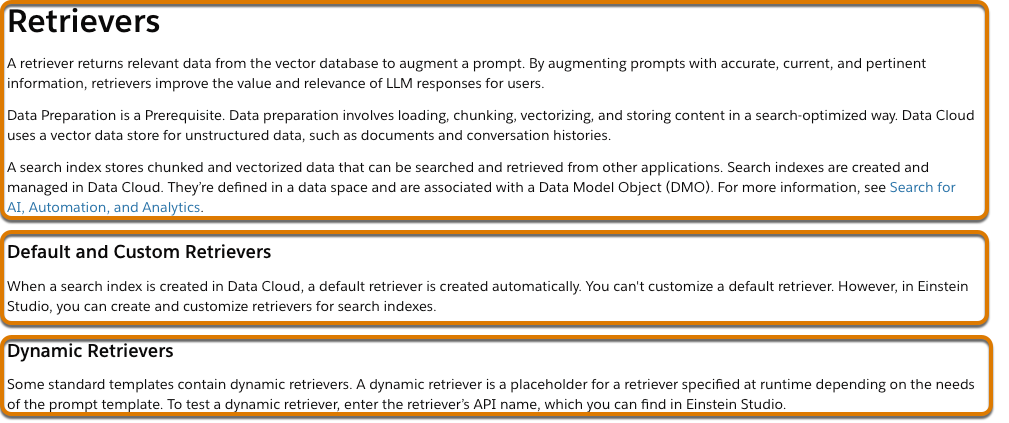
En eksempeldel af det resulterende segmentdatamodelobjekt indeholder disse registreringer.
| Sekvensnummer for segment | Fragment | Opdel DaTAsource-objekt | Datakilde |
|---|---|---|---|
| 1 | Retrievers A retriever returns relevant data from the vector database
to augment a prompt. By augmenting prompts with accurate, current, and pertinent
information, retrievers improve the value and relevance of LLM responses for
users. . . |
DataSourceObject__c |
DataSource__c |
| 2 | Default and Custom Retrievers When a search index is created in Data
Cloud, a default retriever is created automatically. You can't customize a default
retriever. However, in AI Models, you can create and customize retrievers for
search indexes. |
DataSourceObject__c |
DataSource__c |
| 3 | Dynamic Retrievers Some standard templates contain dynamic retrievers.
A dynamic retriever is a placeholder for a retriever specified at runtime
depending on the needs of the prompt template. To test a dynamic retriever, enter
the retriever’s API name, which you can find in AI Models. |
DataSourceObject__c |
DataSource__c |
Når du opretter en søgeindeks i den avancerede Data 360-konstruktør, er afsnitsbevidst segmentering standardstrategien for HTML- og PDF-filer.

Semantisk baseret passageudtrækning
Semantisk baseret passageudtrækning bruger den semantiske betydning, der er indbygget i HTML-tags til at segmentere et dokument i passager. Disse HTML-elementer betragtes som logiske grænser for segmenter.
- Kategori niveau 1-6
<h1-h6> - Tematiske
<hr> - Fed
<b>– Bruges, når den taggede tekst er på sin egen linje, eller hvis den bruges på tekst i et afsnit, hvorfont_weighter indstillet til 700 eller højere, ellerfont_weighter indstillet tilbold - Stærk
<strong>– bruges, når den taggede tekst er på sin egen linje, eller hvis den bruges på tekst i et afsnit, hvorfont_weighter indstillet til 700 eller højere, ellerfont_weighter indstillet til fed - Afsnit
<p>– bruges, når den taggede tekst er på sin egen linje - Linjeskift
<br>– Bruges, når den aktuelle segment overskrider tokengrænsen
Denne tekst indeholder f.eks. adskillige HTML-elementer.
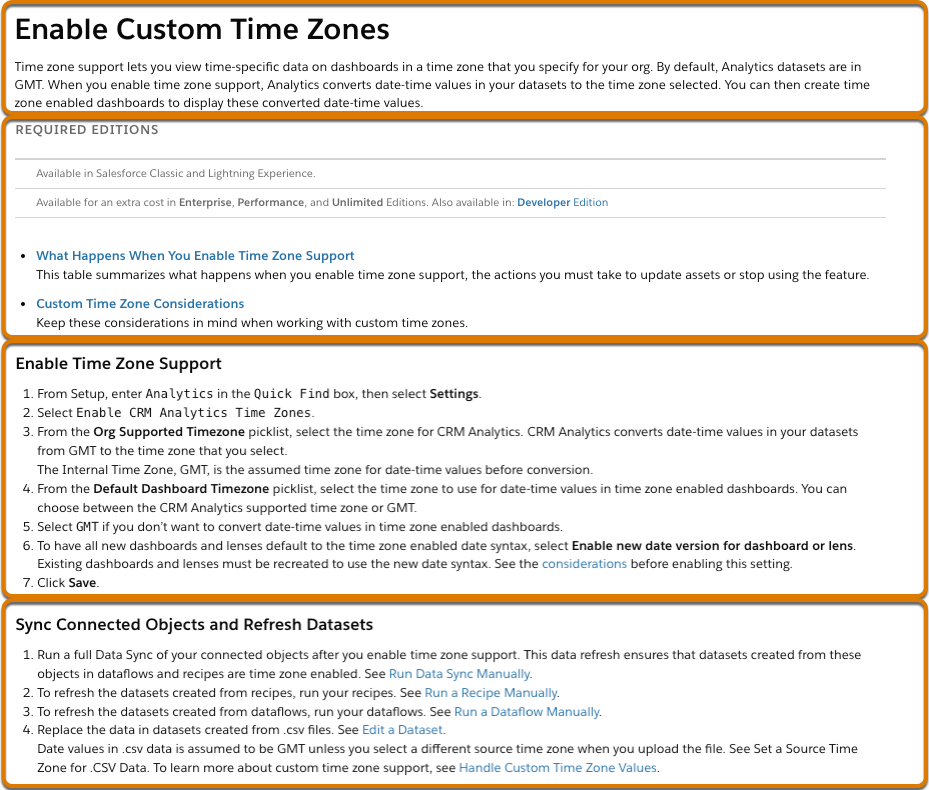
Her er dens HTML-ækvivalent
<h1>Enable Custom Time Zones</h1>
<p>Time zone support lets you view time-specific data...</p>

<h4>REQUIRED EDITIONS</h4>
<p>Available in Salesforce Classic and Lightning Experience</p>
<p>...</p>

<h2>Enable Time Zone Support</h2>
<ul>...</ul>
En eksempeldel af det resulterende segmentdatamodelobjekt indeholder disse registreringer.
| ChunkSequenceNumber | Fragment | Datakildeobjekt | Datakilde |
|---|---|---|---|
1 |
Enable Custom Time Zones Time zone support lets you view time-specific
data.... |
DataSourceObject__c |
DataSource__c |
2 |
REQUIRED EDITIONS Available in Salesforce Classic... |
DataSourceObject__c |
DataSource__c |
3 |
Enable Time Zone Support From Setup, enter
Analytics... |
DataSourceObject__c |
DataSource__c |
4 |
Sync Connected Objects and Refresh Datasets Run a full Data Sync of
your connected objects... |
DataSourceObject__c |
DataSource__c |
Hvis der ikke er noget indhold mellem to overskriftstags, vises disse tags og efterfølgende indhold i et segment i stedet for to. Data 360 kombinerer så mange sidehovedtags, som de kan passe ind i et enkelt segment, hvis der ikke er noget indhold mellem overskrifterne.
Data 360 bruger som standard først den semantiske metode, men hvis nogle resulterende passager er for lange, behandles de yderligere ved brug af vinduesbaseret passageudtrækning. Vinduesbaseret udtrækning bruger elementer på blokniveau som f.eks. <div> og <p> tags eller rå tekst adskilt af linjeskift <br> til at segmentere dokumenter i passager. Hvis et afsnit ikke indeholder HTML, udføres aggregeringen på sætningsniveau.
Samtalebaseret segmentering
Samtalebaseret segmentering segmenterer afskrifter af data fra lyd- og videofiler i segmenter, der typisk adskilles, når stemmen ændres.
Under afskrift, hvis der er flere højttalere, repræsenterer hver del tale for en individuel højttaler.
Her er de første få linjer af en afskrift.
"Hello? Hi Alex, it's Sam from Bullseye. I didn't hear from you yesterday, so I wanted to check in. Hi Sam, sorry about that."En del af det resulterende segmentdatamodelobjekt indeholder disse registreringer.
| ChunkSequenceNumber | Fragment | Starttidsstempel | Sluttidsstempel | Højttaler |
|---|---|---|---|---|
1
|
Hello?
|
1.051
|
1.253
|
SPEAKER_00
|
2
|
Hi Alex, it 's Sam from Bullseye. I didn't hear from you yesterday, so I
                  wanted to check in.
|
3.203
|
8.418
|
SPEAKER_01
|
3
|
Hi Sam, sorry about that.
|
10.263
|
11.546
|
SPEAKER_00
|
Forbered feltopdeling
Når du har brug for at tilføje yderligere metadata for at angive kontekst for segmenter, der er genereret fra DMO'er eller UDMO'er, skal du forudbestille felter til segmenter. F.eks. kunne Description feltet i en Knowledge artikel overstige den optimale segmentstørrelse for prompt-baseret hentning. Ved at sætte Title på forkant med segmentet kan du angive mere kontekst i meddelelsesresultaterne.
Denne tabel indeholder nogle eksempler på nyttige metadatafelter.
| Type | Eksempler på metadatafelter |
|---|---|
| DMO (Knowledge) |
|
| UDMO (External blob store connectors) | Filsti |
| UDMO (webcrawler- eller oversigtskortforbindelser) |
|
Konfigurer felter til at forudsige segmenter fra DMO'er eller UDMO'er i den avancerede opsætning af søgeindekset for vektor- eller hybridsøgning.
Maks. tokengrænsen for en segment er 512, så sørg for, at eventuelle felter, du vælger til forhåndsvistelse, har værdier inden for denne grænse. Data 360 springer over ventende felter, hvis længden af de ventede felter er større end 512 tokener.
Kodeudvidelse
Brug en tilpasset segmenteringsfunktion, når indbyggede segmenteringsstrategier ikke opfylder dine indholds- eller hentekrav. Tilpassede funktioner er nyttige, når segmentgrænser skal følge domænespecifik logik, f.eks. bevare relaterede afsnit fra komplekse PDF'er eller anvende meddelelsesstyret segmentering gennem LLM-gatewaykald.
Ved at bruge kodeudvidelsen skal du implementere en tilpasset funktion og vælge den som segmenteringsstrategi i søgeindekset Avanceret opsætning. For end-to-end-arbejdsflowet for at oprette, validere, implementere og bruge en tilpasset segmenteringsfunktion kan du se Brug tilpassede funktioner i Data 360.
