위치:
청크 전략
Data 360은 몇 가지 청크 전략을 지원합니다. Data 360은 작업하는 콘텐츠 유형을 기반으로 최적의 청크 전략을 자동으로 선택합니다.
예를 들어, 가장 관련성이 높은 컨텍스트와 시맨틱한 의미를 제공하는 필드, 해당 필드를 분리하는 방법, 검색된 결과가 Einstein Gen AI, 자동화, 분석 응용 프로그램에서 사용될 것으로 예상되는 방법을 고려하십시오. 예를 들어, Knowledge 기사 DMO의 사용자 정의 텍스트 필드를 통과 추출 전략을 사용하여 Knowledge 개체 간에 검색할 때 시맨틱하게 유사한 결과를 쉽게 반환할 수 있습니다.
섹션 인식 청크
섹션 인식 청크는 제목 및 머리글 요소를 사용하여 문서를 청크합니다. 섹션 제목 또는 머리글 요소 아래의 모든 텍스트가 Data 360에 새 섹션 제목 또는 머리글 요소가 나타날 때까지 함께 청크됩니다. 이를 통해 문서의 구조를 기반으로 일관된 섹션에서 콘텐츠를 청크할 수 있습니다.
섹션은 임의로 분할되지 않습니다. 청크는 항상 자연 콘텐츠 경계를 준수하여 가독성과 컨텍스트를 유지합니다. 짧은 단락이나 목록 항목이 독립형 섹션으로 잘못 식별되는 경우가 있습니다. 이로 인해 청크가 지나치게 작을 수 있습니다. 이를 방지하려면 검색 색인 만들 때 다음 설정을 사용하십시오.
- 최대 토큰: 인접 작은 섹션을 더 큰 청크로 결합하여 일관성을 저하하지 않고 청크 크기를 최적화합니다. 최대 토큰 설정이 청크에 미치는 영향을 참조하십시오.
- 겹침 토큰: 단일 섹션에서 여러 개의 청크가 생성된 경우에만 사용됩니다. 각 청크의 끝에서 다음 청크의 시작으로 추가할 토큰 수를 지정합니다. 이렇게 하면 연속 청크 간에 상황적 겹침이 생성되어 원활한 전환과 검색 및 검색과 같은 과업의 성능이 향상됩니다.
결합된 콘텐츠가 구성된 토큰 제한 이내에 남아 있는 경우 여러 단락을 단일 청크로 그룹화할 수 있습니다.
토큰 제한에 도달하면 청크 논리가 문장 또는 단락 중간에 분할되지 않으므로 깨끗한 휴식을 보장합니다. 대신 단락 끝까지 확장하여 청크 전반에서 시맨틱하고 구조적인 무결성을 유지합니다.
예를 들어 이 텍스트는 제목 및 다음 섹션 머리글을 기반으로 섹션으로 나눠집니다.
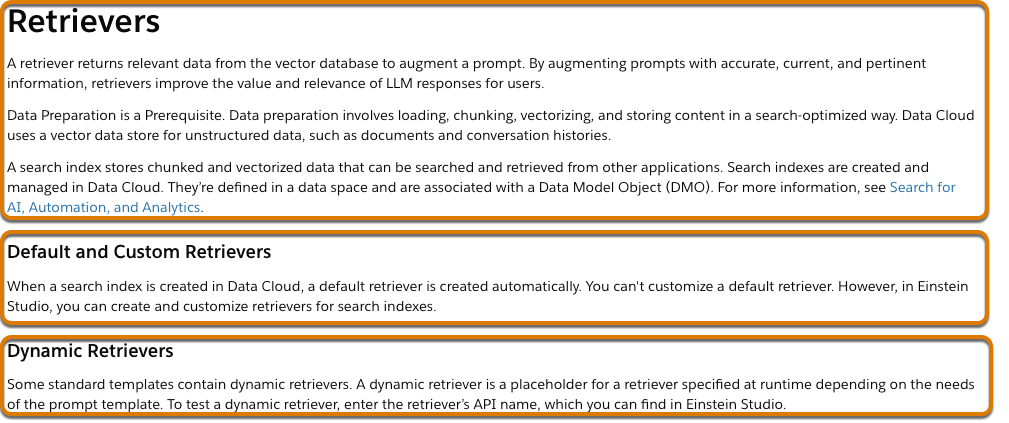
결과 청크 데이터 모델 개체의 예제 부분에 다음 레코드가 포함됩니다.
| 순서 번호 | 청크 | 청크 DaTAsource 개체 | 데이터 소스 |
|---|---|---|---|
| 1 | Retrievers A retriever returns relevant data from the vector database
to augment a prompt. By augmenting prompts with accurate, current, and pertinent
information, retrievers improve the value and relevance of LLM responses for
users. . . |
DataSourceObject__c |
DataSource__c |
| 2 | Default and Custom Retrievers When a search index is created in Data
Cloud, a default retriever is created automatically. You can't customize a default
retriever. However, in AI Models, you can create and customize retrievers for
search indexes. |
DataSourceObject__c |
DataSource__c |
| 3 | Dynamic Retrievers Some standard templates contain dynamic retrievers.
A dynamic retriever is a placeholder for a retriever specified at runtime
depending on the needs of the prompt template. To test a dynamic retriever, enter
the retriever’s API name, which you can find in AI Models. |
DataSourceObject__c |
DataSource__c |
Data 360 고급 빌더에서 검색 색인 구성을 만들 경우 섹션 인식 청크는 HTML 및 PDF 파일의 기본 청크 전략입니다.

시맨틱 기반 통로 추출
시맨틱 기반 통과 추출은 HTML 태그에 내재된 시맨틱 의미를 사용하여 문서를 통과로 청크합니다. 해당 HTML 요소는 청크의 논리적 경계로 간주됩니다.
- 제목 레벨 1-6
<h1-h6> - 주제별 휴식
<hr> - 굵은
<b>- 태그가 지정된 텍스트가 자체 줄에 있거나font_weight가 700 이상으로 설정되거나font_weight이bold로 설정된 단락의 텍스트에 사용되는 경우 사용 - 강력한
<strong>- 태그가 지정된 텍스트가 자체 줄에 있는 경우 또는font_weight가 700 이상으로 설정되거나font_weight가 굵게 표시된 단락의 텍스트에 사용되는 경우 사용 - 단락
<p>- 태그가 지정된 텍스트가 자체 줄에 있는 경우 사용 - 줄 바꿈
<br>- 현재 청크가 토큰 제한을 초과하는 경우 사용
예를 들어 이 텍스트에는 몇 가지 HTML 요소가 포함되어 있습니다.
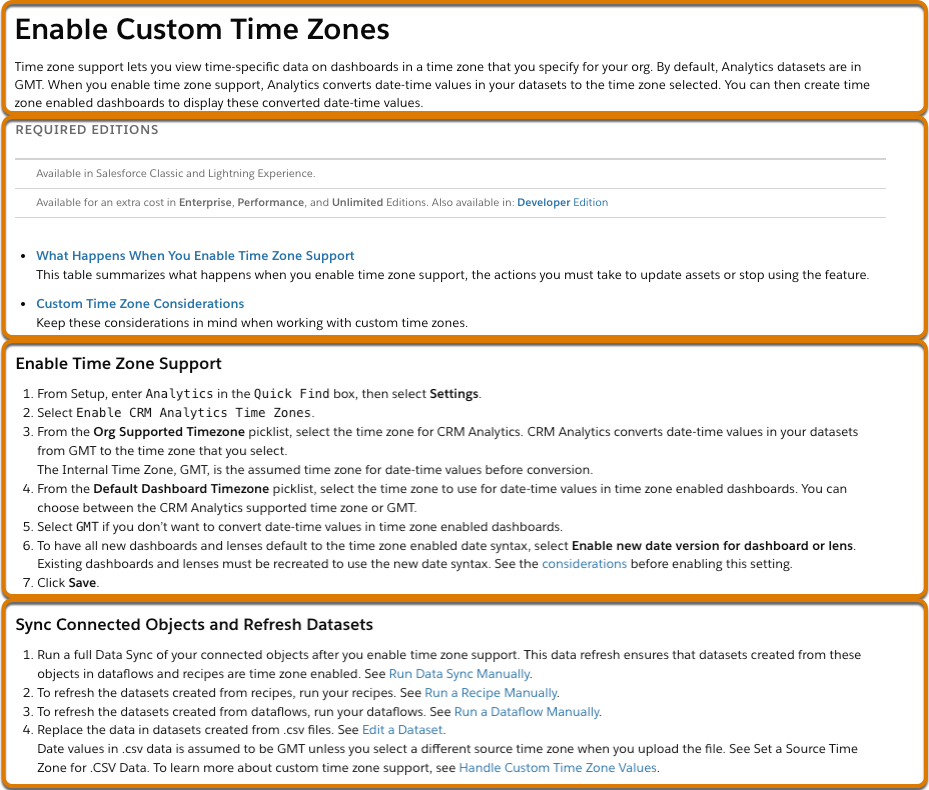
다음은 HTML에 상응하는 예시입니다.
<h1>Enable Custom Time Zones</h1>
<p>Time zone support lets you view time-specific data...</p>

<h4>REQUIRED EDITIONS</h4>
<p>Available in Salesforce Classic and Lightning Experience</p>
<p>...</p>

<h2>Enable Time Zone Support</h2>
<ul>...</ul>
결과 청크 데이터 모델 개체의 예제 부분에 다음 레코드가 포함됩니다.
| ChunkSequenceNumber | 청크 | 데이터 소스 개체 | 데이터 소스 |
|---|---|---|---|
1 |
Enable Custom Time Zones Time zone support lets you view time-specific
data.... |
DataSourceObject__c |
DataSource__c |
2 |
REQUIRED EDITIONS Available in Salesforce Classic... |
DataSourceObject__c |
DataSource__c |
3 |
Enable Time Zone Support From Setup, enter
Analytics... |
DataSourceObject__c |
DataSource__c |
4 |
Sync Connected Objects and Refresh Datasets Run a full Data Sync of
your connected objects... |
DataSourceObject__c |
DataSource__c |
두 머리글 태그 사이에 콘텐츠가 없는 경우 해당 태그와 후속 콘텐츠가 두 개가 아닌 하나의 청크에 표시됩니다. 머리글 사이에 콘텐츠가 없는 경우 Data 360은 머리글 태그를 단일 청크에 적합한 수만큼 결합합니다.
기본적으로 Data 360은 먼저 시맨틱 기반 메서드를 사용하지만, 일부 결과 통과가 너무 길면 윈도우 기반 통과 추출을 사용하여 추가로 처리됩니다. 창 기반 추출은 <div> 및 <p> 태그와 같은 블록 수준 요소 또는 줄바꿈 <br>로 구분된 원시 텍스트를 사용하여 문서를 통과로 청크합니다. 단락에 HTML이 포함되어 있지 않으면 문장 수준에서 집계가 완료됩니다.
대화 기반 청크
대화 기반 청크 세그먼트는 오디오 및 비디오 파일의 데이터를 청크로 기록하며, 일반적으로 음성이 변경되면 분리됩니다.
기록 중에 여러 화자가 있는 경우 각 청크는 개별 화자의 발화를 나타냅니다.
다음은 기록의 처음 몇 줄입니다.
"Hello? Hi Alex, it's Sam from Bullseye. I didn't hear from you yesterday, so I wanted to check in. Hi Sam, sorry about that."결과 청크 데이터 모델 개체의 일부에 다음 레코드가 포함됩니다.
| ChunkSequenceNumber | 청크 | 타임스탬프 시작 | 종료 타임스탬프 | 화자 |
|---|---|---|---|---|
1
|
Hello?
|
1.051
|
1.253
|
SPEAKER_00
|
2
|
Hi Alex, it 's Sam from Bullseye. I didn't hear from you yesterday, so I
                  wanted to check in.
|
3.203
|
8.418
|
SPEAKER_01
|
3
|
Hi Sam, sorry about that.
|
10.263
|
11.546
|
SPEAKER_00
|
필드 청크 준비
추가 메타데이터를 추가하여 DMO 또는 UDMO에서 생성된 청크에 대한 컨텍스트를 제공해야 하는 경우 필드를 청크에 추가합니다. 예를 들어, Knowledge 기사의 Description 필드는 프롬프트 기반 검색의 최적의 청크 크기를 초과할 수 있습니다. Title 필드를 청크 앞에 추가하면 프롬프트 결과에 추가 컨텍스트를 제공할 수 있습니다.
다음 표는 유용한 메타데이터 필드의 몇 가지 예를 제공합니다.
| 유형 | 메타데이터 필드 예 |
|---|---|
| DMO(Knowledge 기사) |
|
| UDMO(외부 Blob 스토어 커넥터) | 파일 경로 |
| UDMO(웹 크롤러 또는 사이트 맵 커넥터) |
|
벡터 검색 또는 하이브리드 검색의 검색 색인 고급 설정에서 DMO 또는 UDMO의 청크를 미리 표시하도록 필드를 구성합니다.
청크에 대한 최대 토큰 제한은 512이므로 미리 보기에 선택한 필드에 해당 제한 이내의 값이 있는지 확인하십시오. 보류된 필드의 길이가 512 토큰보다 크면 Data 360은 보류 중인 필드를 건너뛰며,
코드 확장
내장형 청크 전략이 콘텐츠 또는 검색 요구 사항을 충족하지 않는 경우 사용자 정의 청크 함수를 사용합니다. 사용자 정의 함수는 복잡한 PDF에서 관련 섹션을 유지하거나 LLM 게이트웨이 호출을 통해 프롬프트 구동 청크를 적용하는 등 청크 경계가 도메인별 논리를 따라야 하는 경우 유용합니다.
코드 확장을 사용하여 사용자 정의 함수를 구축하고 검색 색인 고급 설정에서 청크 전략으로 선택합니다. 사용자 정의 청크 함수를 작성, 검증, 배포 및 사용하는 종단간 워크플로의 경우 Data 360에서 사용자 정의 함수 사용을 참조하십시오.
