Você está aqui:
Exemplo de ciclo de vida do incidente: Um dia na vida de uma equipe de incidentes
Um gerente de incidente no Take-Out observa um pico em casos de clientes vindo de vários canais, incluindo email, chat, mensagens e telefone, sobre erros referentes a um novo código de desconto de marketing.
Edições obrigatórias
| Exibir edições com suporte. |
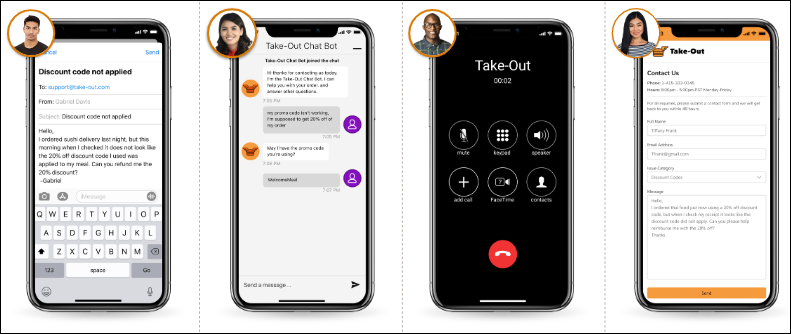
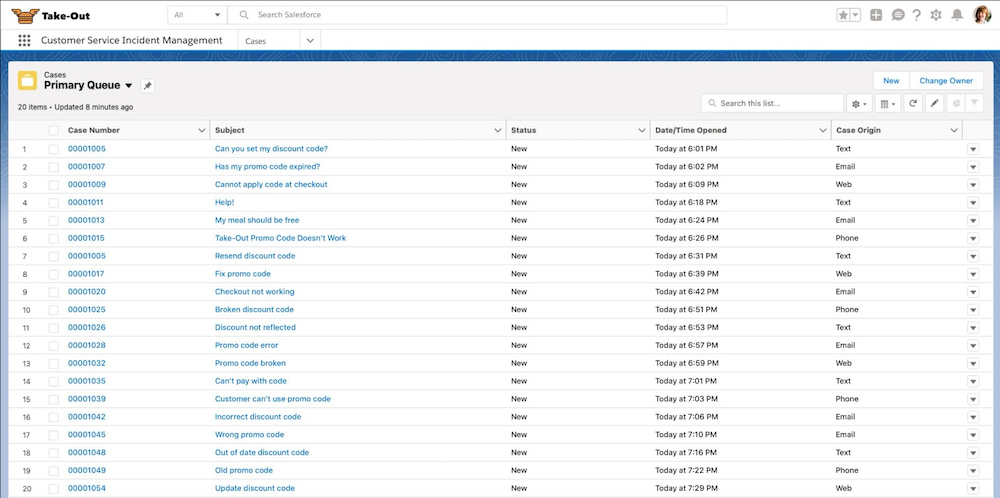
- O gerente de incidentes analisa casos novos e abertos e vê dezenas de casos sobre um código de desconto com falha.
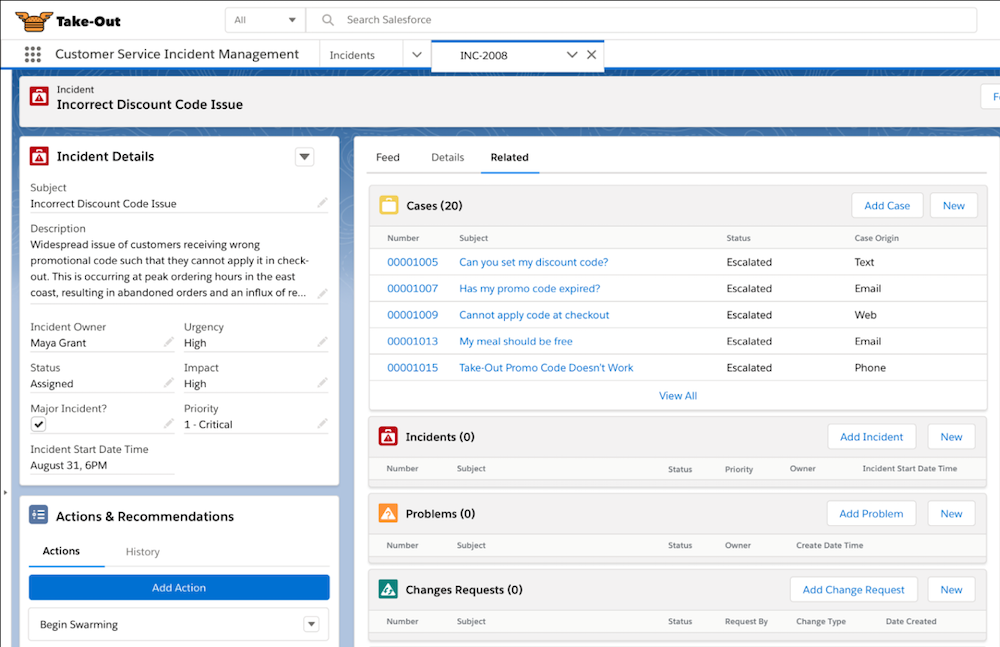
- O gerente de incidente cria um registro de incidente. O registro de incidente contém informações sobre os erros com o código de desconto, quais territórios de serviço são afetados e o nível de urgência.
- Para rastrear casos relacionados enquanto o incidente é investigado e remover problemas relacionados a incidentes das filas do representante de suporte, o gerente de incidentes vincula casos da lista relacionada Problemas relacionados a casos.
- Um membro da equipe de resolução de incidentes é atribuído ao incidente por meio do Omni-Channel com base em seu conhecimento sobre problemas de códigos de desconto.
- O proprietário do incidente inicia os fluxos Alterar proprietário do caso para proprietário do incidente no componente Ações e recomendações para que todos os casos vinculados agora pertençam a ele. Os proprietários dos casos anteriores agora podem voltar a utilizar novos casos de cliente e não serão distraídos por casos relacionados ao incidente.
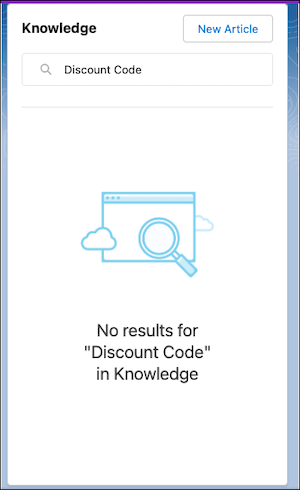
- O proprietário do incidente pesquisa artigos do Knowledge relevantes no componente Knowledge, mas não consegue encontrar soluções alternativas conhecidas.
- O proprietário do incidente decide iniciar um mutirão no Slack com outros especialistas no assunto usando o fluxo Iniciar mutirão e o Localizador de especialistas. Como uma equipe, os especialistas em códigos de desconto trabalham juntos no mutirão para localizar o problema, identificar todos os clientes afetados e convidar os membros da equipe do DevOps para colaborar na resolução.
- Um membro da equipe DevOps cria um registro de problema no Salesforce para capturar os detalhes do problema e investigar a causa-raiz. A equipe de DevOps começa a trabalhar com a depuração do problema, identifica os ativos afetados e vincula o problema ao incidente para que o proprietário do incidente possa manter os clientes informados.
- O proprietário do incidente adiciona um banner de transmissão ao site do Take-Out para alertar usuários autenticados sobre o incidente e oferecer um código de desconto alternativo para evitar novos casos.
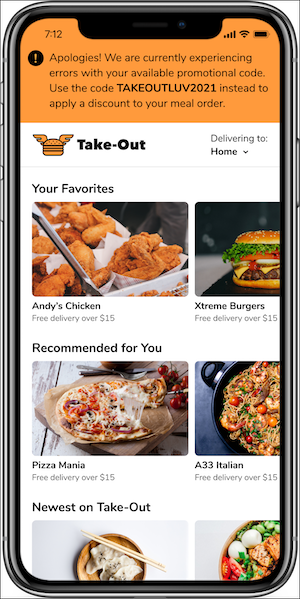
- Assim que a equipe de DevOps identificar o erro que está causando os erros de código de desconto, um membro da equipe criará uma solicitação de alteração para capturar as etapas para resolução.
- Na solicitação de alteração, um membro do DevOps cria um plano de trabalho para descrever as etapas necessárias para resolver o incidente e restaurar o código de desconto.
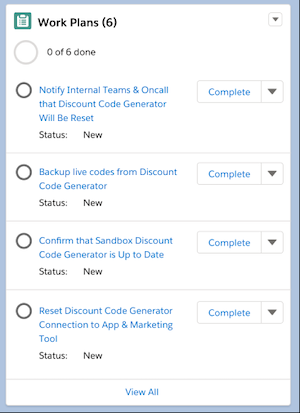
- Após a conclusão e a verificação de todas as etapas, a equipe de resposta ao incidente inicia um fluxo de aprovação para autorizar a correção de emergência pelo Conselho consultivo de alteração.
- Depois que a correção for aprovada e o incidente for resolvido, a equipe de incidente iniciará o fluxo Fechar solicitação de alteração e problemas relacionados no componente Ações e recomendações. O fluxo fecha automaticamente a solicitação de alteração e seu problema, incidente e casos relacionados.
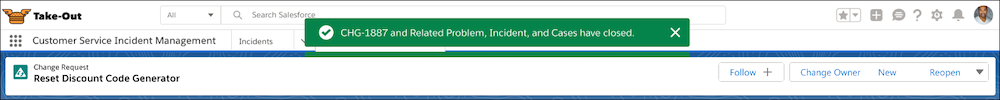
- O proprietário do incidente remove o banner do site do Take-Out e envia um email de transmissão a todos os clientes afetados para informar que o código de desconto está funcionando novamente.
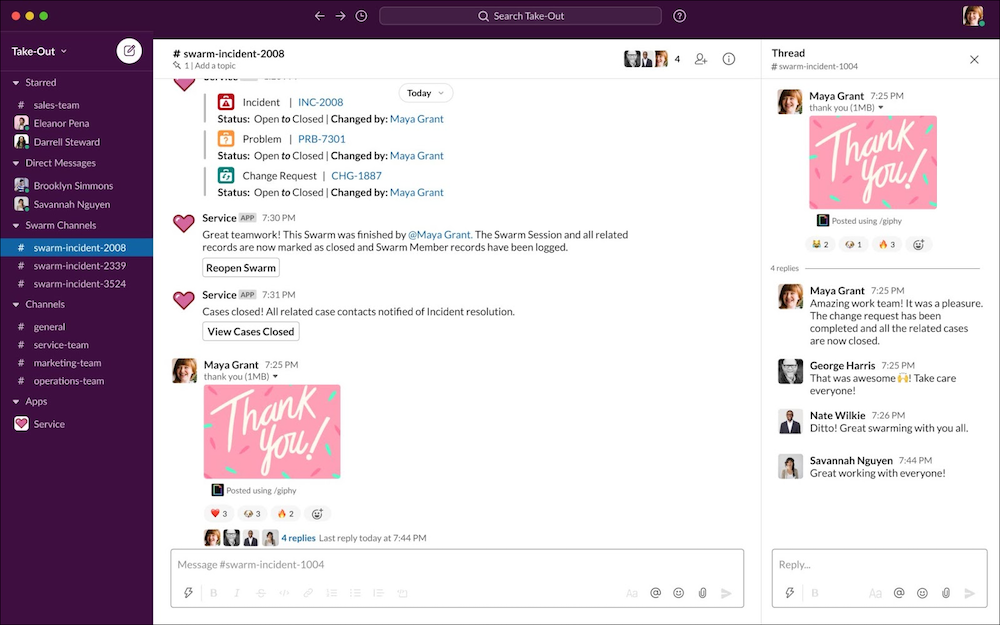
- O proprietário do incidente fecha o mutirão e a equipe comemora sua rápida reflexão e colaboração no Slack.
Este artigo resolveu seu problema?
Diga-nos para podermos melhorar!
