您在此处:
什么是数据库?
Agentforce 数据库通过将 Agentforce Agents 连接到您信任的数据源来增强 AI 功能的准确性。数据库使用非结构化或半结构化数据,以便它们能够获取存在于 Web、文档中的大量信息,或者作为字段中的大量文本输入,并将其转化为更有用、可搜索的信息。
在创建数据库时,它会自动执行Data 360 的若干配置步骤和提示生成器,例如将数据流推送到Data 360、映射数据对象以及创建搜索索引和检索器。通过这些步骤自动完成,可轻松将客服人员链接到数据。您可以从 Agentforce 数据库设置或通过 Agentforce Builder 创建和配置库。
接地、分块和分度
基础训练将特定于域的 Knowledge 或客户信息添加到提示中,让 LLM 上下文更准确地响应问题或任务。基础来源可以包括 Knowledge 文章、上传的文件或对话脚本。冗长而复杂的 Knowledge 文章和上传的文件可能需要大量的时间和处理能力来搜索正确的信息,并且 LLM 在一次调用中可以处理的文本量有最大标记或字数限制。为了提高搜索效率,提高相关性,并处理非常大的数据集,我们将数据源分成更小的部分,称为块。可以对多种类型的数据进行分块,包括文本、图像,甚至是音频文件。
在数据拆分为块后,对其进行索引、组织和分类。索引简化了 AI 工具数据块的搜索和检索。当 AI 客服人员需要信息或用户提问时,我们使用搜索索引对块进行排序,并查找与特定查询或任务最相关的块,而不是搜索整个文档。搜索索引中的每个块与相似性分数进行比较,相似性分数指示查询和块之间的文本匹配程度。相似性得分高的块指向相关文章或来源,然后返回并添加到提示中。通过使用这种策略,我们可以将相关的、特定于上下文的信息添加到提示中,而不会超出令牌的限制,并且 LLM 可以起草适合不同情况和组织的响应。
检索器
检索器就像数据和功能之间的指针。它们旨在自动从不同的数据库、系统或平台中提取和提供相关数据,减少手动数据收集,同时标准化检索的数据集。检索器在搜索引擎、问答系统和推荐系统等应用程序中尤其重要。当用户提出问题或从 AI 获得帮助时,分配给每个数据库的检索器会确定 Data 360 中的哪些数据集对 Salesforce 中的 AI 工具可用。请参阅使用检索扩充生成。
创建数据库时会发生什么?
配置并保存数据库后,连接数据与 AI 客服人员和功能的过程就会开始。首先,创建数据流,然后是数据湖和数据模型对象。然后,数据湖对象与数据模型对象映射。映射数据湖和模型对象后,将创建搜索索引。对于要创建的搜索索引,上述步骤必须成功并处于活动状态。
创建搜索索引后,数据分块将开始。分块时间取决于 Knowledge 文章或上载文件的数量、大小和复杂性以及选择分块的 Knowledge 字段的数量等因素。基于 Web 搜索的数据库不会创建搜索索引,只会创建检索器。对于基于文件或 Knowledge 的库,在分块完成并且搜索索引准备就绪后,将创建检索器。无论设置如何,每个 Agentforce 数据库都有自己的检索器。检索器可以指向相同的搜索索引,但每个指针都是唯一的。
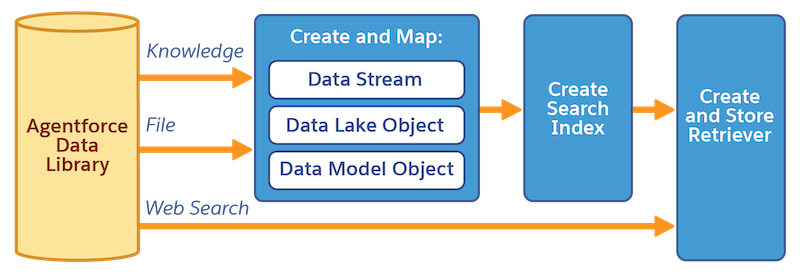
您可以从数据库设置页面中的状态卡监控每个步骤。状态卡将在每个阶段完成时向您逐步介绍,并链接到 Data 360 中的基础 Data Cloud 对象,以便您可以检查和管理完整的数据漏斗。
在索引准备就绪并创建检索器时,客户可以使用带有 AI 客服人员和功能的数据库配置。
数据库如何在运行时工作?
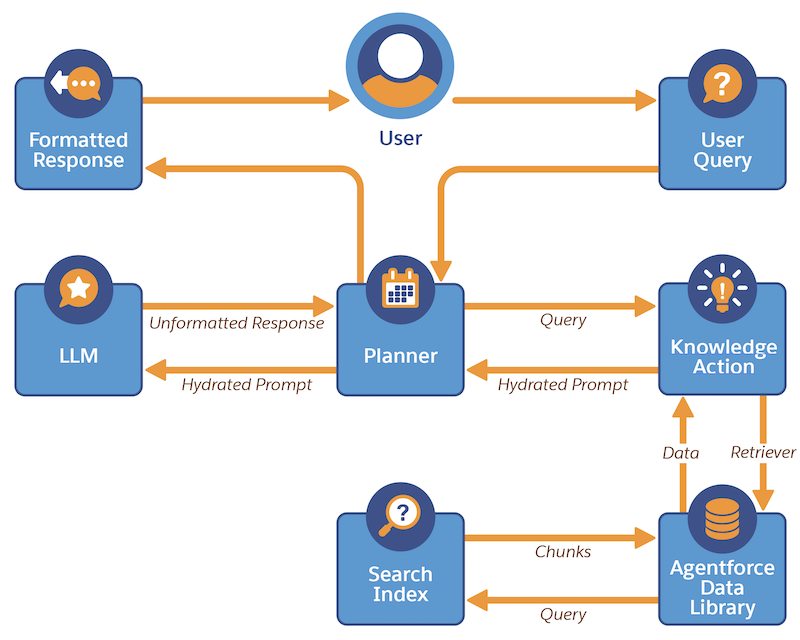
在运行时,用户的查询被添加到提示模板中,提示模板引用连接到相关数据的检索器。然后,系统会梳理搜索索引,以查找最相关的信息,并将其合并回提示。LLM 接收此丰富提示,并接受用户的查询、添加的信息和提示指令来生成响应。然后,服务计划器检查此响应,以确保它符合提示说明。最后,最终用户会收到一个响应,该响应会使用相关的特定于域的信息来回答查询,并针对特定的任务进行定制。
客服人员操作和数据库
操作决定了客服人员可以完成的作业。默认情况下,客服人员会包含标准操作,并且可以构建为使用特定产品。例如,当用户向 AI 客服人员提问时,“使用 Knowledge 回答问题”客服人员操作用于根据相应 Agentforce 数据库中的数据回答查询。请参阅将数据库分配到客服人员和客服人员操作:用 Knowledge 回答问题。
